
클라우드 기초: 리전·VPC·IAM·컴퓨팅·스토리지·관리형 DB
이 시리즈는 쿠버네티스와 클라우드(AWS·GCP·Azure 공통 개념)를 실무 관점에서 정리한 기록이다. 핵심 개념·코드 예제·실전 함정(gotcha) 중심으로, 학습과 설계 리뷰·장애 대응에 바로 쓸 수 있게 구성했다. 각 편은 독립적으로 읽을 수 있고, 순서대로 보면 클러스터 내부 구조에서 클라우드 운영까지 하나의 흐름으로 이어진다.
이번 편에서는 클라우드 기초를 세 가지 질문으로 수렴시켜 정리한다. 무엇을 어디에 배치할 것인가(컴퓨팅·스토리지·DB), 누가 무엇에 접근할 수 있는가(IAM·네트워크 경계), 어디까지 장애를 견딜 것인가(리전·AZ·RTO/RPO). 이 세 축은 독립이 아니라 하나의 결정 사슬이며, 서비스 모델 선택 하나가 이후 네트워크·권한·비용 설계를 전부 제약한다. 클러스터 내부 구조는 쿠버네티스 기초에서 다뤘고, 이 편은 그 위에 올라가는 클라우드 리소스를 어떻게 고르고 연결하는지에 집중한다. 선언적으로 인프라를 관리하는 방법은 다음 편인 IaC와 GitOps에서 이어진다. 서술은 AWS를 기준으로 하되 GCP/Azure 대응 서비스를 병기한다.
- IaaS/PaaS/SaaS 경계와 공동 책임 모델에서 고객에게 끝까지 남는 네 가지 책임을 구분한다
- 리전·AZ·엣지 구조와 N+1 AZ 배치를 기준으로 가용성 등급과 RTO/RPO 목표를 세운다
- VPC의 CIDR·서브넷·라우팅·게이트웨이와 보안 그룹·NACL 경계를 설계 순서대로 잡는다
- 컴퓨팅·스토리지·관리형 DB·메시징의 선택 기준을 한 표에서 비교한다
- IAM 역할 수임과 정책 평가 순서, 관리형 쿠버네티스(EKS/GKE/AKS) 차이, 실전 함정과 체크리스트를 정리한다
1. 서비스 모델(IaaS/PaaS/SaaS)과 공동 책임
클라우드 서비스 모델은 “스택의 어느 지점부터 내가 책임지는가”를 나누는 기준이다. IaaS는 가상화 위를, PaaS는 런타임 위를, SaaS는 완성된 앱 위를 고객에게 넘긴다.
| 모델 | 고객이 관리 | 제공자가 관리 | 대표 예 |
|---|---|---|---|
| IaaS | OS 패치, 런타임, 앱, 데이터, 네트워크 설정 | 물리 서버, 하이퍼바이저, 스토리지 하드웨어 | EC2, GCE, Azure VM |
| PaaS | 앱 코드, 데이터, 설정 | OS/런타임/스케일링/제어 평면 | RDS, EKS/GKE/AKS, App Service |
| SaaS | 데이터, 접근 권한, 설정 | 전체 스택 | Notion, Workspace, M365 |
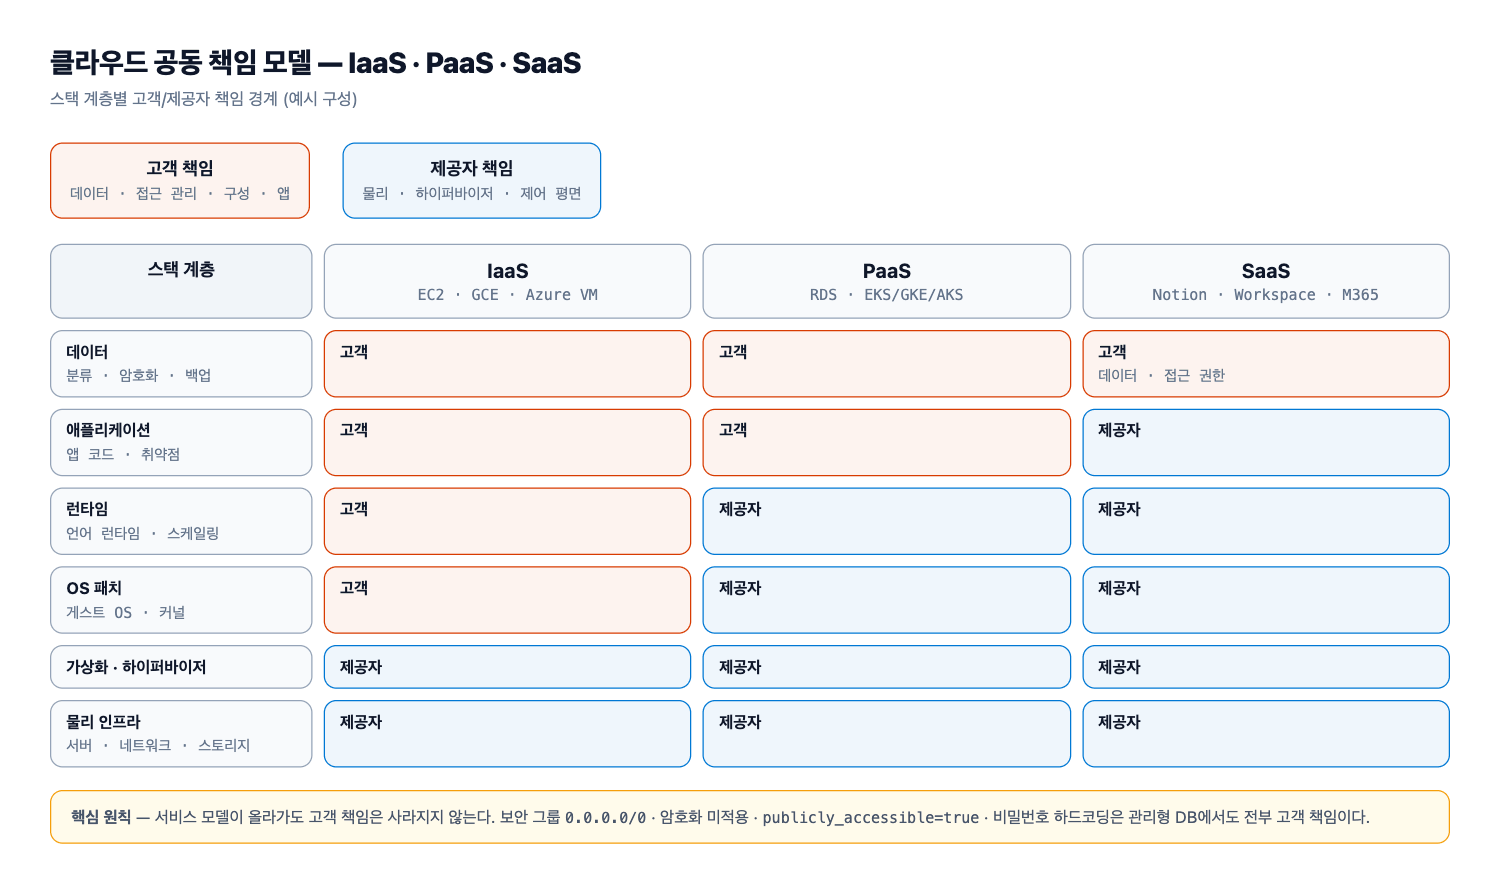
위 다이어그램은 클라우드 스택의 각 계층(데이터·앱·런타임·OS·가상화·물리)을 IaaS/PaaS/SaaS별로 나눠, 어느 계층이 고객 책임이고 어느 계층이 제공자 책임인지 보여준다. 서비스 모델이 올라갈수록 고객이 직접 관리하는 계층이 줄어들 뿐, 데이터와 접근 관리 책임은 줄어들지 않는다.
공동 책임 모델(Shared Responsibility Model) 에서 절대 변하지 않는 고객 책임은 네 가지다.
- 데이터 — 분류, 암호화, 보존/삭제, 백업 검증
- 접근 관리 — IAM 정책, 키 로테이션, 최소 권한
- 구성 — 보안 그룹, 퍼블릭 노출, 암호화 활성화 여부
- 앱 계층 — 취약점, 입력 검증, 의존성 패치
제공자는 물리 보안, 하이퍼바이저, 관리형 서비스의 제어 평면(control plane)을 책임진다. 흔한 함정: “관리형 DB니까 안전하다”는 착각이다. RDS를 띄워도 보안 그룹 0.0.0.0/0, 스토리지 암호화 미적용, publicly_accessible = true, 관리자 비밀번호 하드코딩은 전부 고객 책임이다. AWS Config 규칙 rds-instance-public-access-check 같은 가드레일을 처음부터 붙여라.
2. 리전·AZ·엣지와 가용성 설계
2.1 리전·AZ·엣지 로케이션
- 리전(Region): 지리적으로 격리된 클러스터. 데이터 주권, 지연, 요금, 서비스 출시 시점이 다르다. 신규 서비스가
ap-northeast-2에 없는 경우가 흔하므로 설계 전 리전별 서비스 목록을 확인한다. - 가용 영역(AZ, Availability Zone): 하나의 리전 안에서 전원·냉각·네트워크가 물리적으로 분리된 데이터센터 그룹. AZ 간 지연은 보통 한 자릿수 ms.
- 엣지 로케이션(PoP): CloudFront/Route53/Global Accelerator가 동작하는 캐시 거점. 오리진(origin)까지 가지 않고 사용자 근처에서 응답한다.
가용성 설계의 기본형은 N+1 AZ 배치다. 최소 2개 AZ, 프로덕션은 3개 AZ에 인스턴스·서브넷·DB를 분산한다. 목표를 숫자로 고정해라.
2.2 가용성 등급과 AZ ID 함정
| 등급 | 구성 | 대략 RTO | 대략 RPO |
|---|---|---|---|
| 단일 AZ | 1 AZ, 스냅샷 백업 | 수 시간 | 수십 분 ~ 수 시간 |
| Multi-AZ (active-passive) | 2~3 AZ, 자동 페일오버 | 수 분 | 수 초~수 분 |
| Multi-Region active-active | 2+ 리전, 글로벌 라우팅, 복제 | 수 초 | 0에 가까움 |
Gotcha — AZ 이름과 AZ ID: ap-northeast-2a는 계정마다 실제 물리 AZ가 다르다(AWS가 계정별로 이름을 셔플한다). 여러 계정에서 “같은 AZ”에 배치하려면 aws ec2 describe-availability-zones의 ZoneId(apne2-az1)를 기준으로 정렬하고, Terraform에서는 availability_zone_id를 쓴다. 이걸 모르면 계정 A와 B의 리소스가 실제로 다른 AZ에 깔려 크로스 AZ 트래픽 비용이 터진다.
3. VPC: 서브넷·라우팅·게이트웨이
3.1 CIDR·서브넷·게이트웨이 설계
VPC(Virtual Private Cloud)는 리전 단위 논리 네트워크다. 설계 순서는 항상 CIDR → 서브넷 → 라우팅 → 게이트웨이 → 보안 경계다.
- CIDR 설계:
/16VPC +/20~24서브넷이 무난하다. 온프레미스·다른 VPC와 피어링/Transit Gateway로 연결할 계획이면 CIDR이 겹치면 안 된다. RFC1918(10/8,172.16/12,192.168/16)을 용도별로 분할해 문서화한다. 미래 확장을 위해/16을 쓰고, 서브넷은 AZ별로 절반씩 나눠 낭비를 줄인다. - 퍼블릭/프라이빗 서브넷: 퍼블릭은 라우팅 테이블에 IGW(
0.0.0.0/0)가 있는 서브넷일 뿐이다. 이름이 아니라 라우팅이 정의한다. - IGW(Internet Gateway): VPC당 1개, 양방향 인터넷. NAT Gateway: 프라이빗 서브넷의 아웃바운드 전용, AZ별 배치 권장(장애 격리), 데이터 처리 요금이 붙는다.
- VPC 피어링(Peering): 1:1, 비전이적(not transitive). A-B, B-C가 있어도 A-C는 안 된다. CIDR 중복 불가, 보안 그룹 참조는 같은 리전 내에서만 가능.
- Transit Gateway(TGW): 허브-스포크로 다수 VPC/온프레미스/VPN을 연결. 전이적 라우팅 + 라우팅 테이블로 세그멘테이션. VPC가 4개를 넘거나 온프레미스와 연결하면 TGW가 정답이다.
- VPC 엔드포인트: S3/DynamoDB는 게이트웨이 엔드포인트(무료, 라우팅 테이블에 추가), 나머지 대부분은 인터페이스 엔드포인트(ENI + PrivateLink, 시간당+GB 과금). NAT 비용을 없애고 트래픽을 AWS 백본에 가둔다.
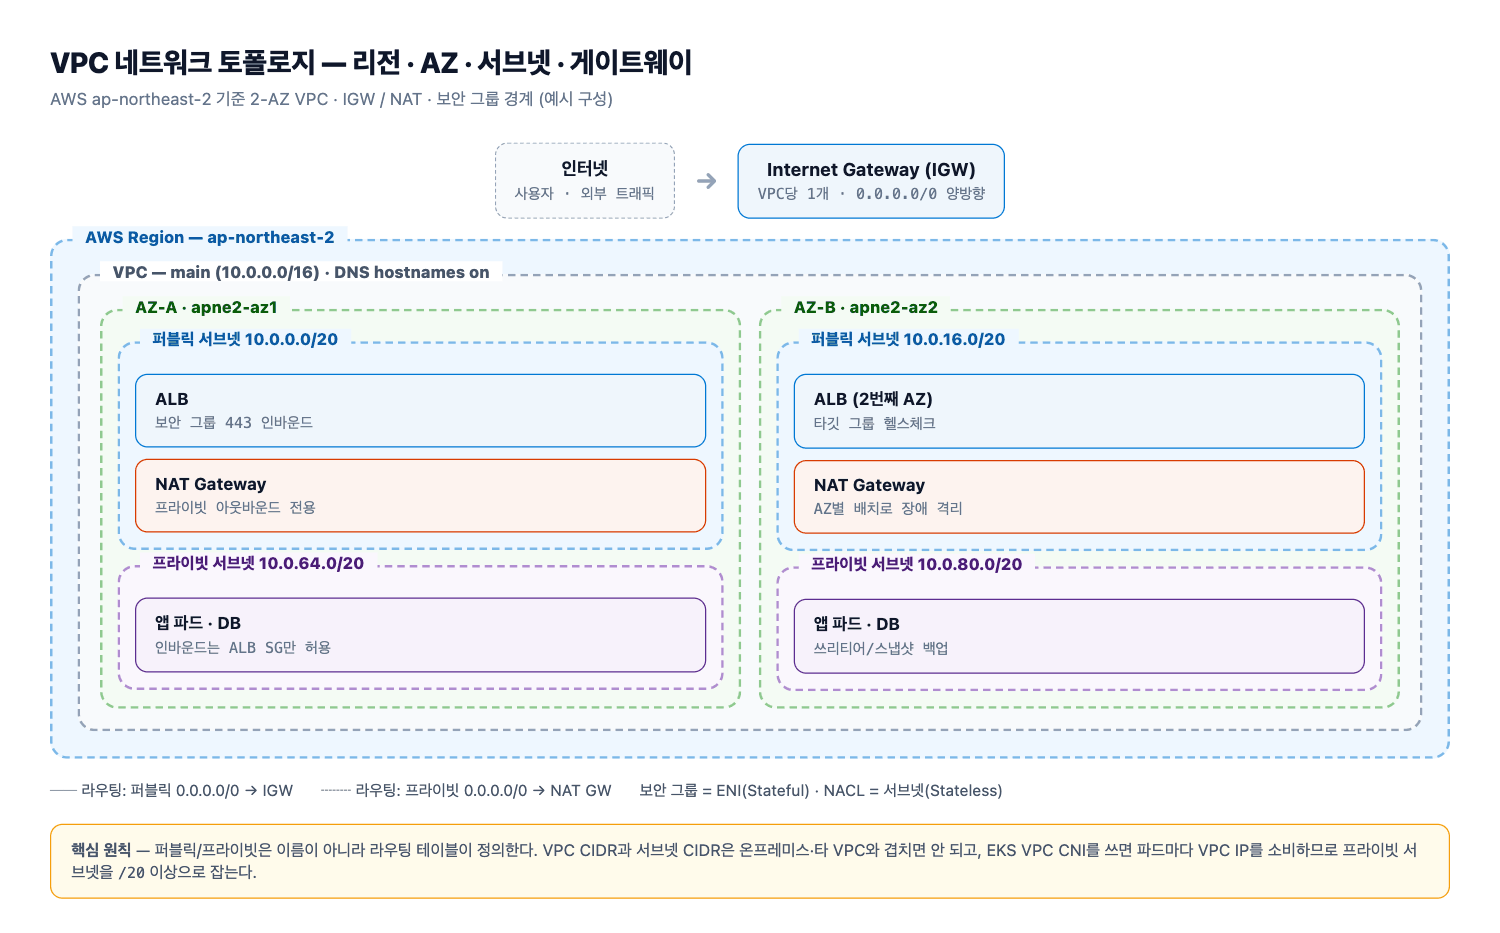
위 그림은 하나의 리전 안에 AZ 두 개를 두고, VPC(10.0.0.0/16) 아래 퍼블릭·프라이빗 서브넷을 나눈 뒤 IGW·NAT 게이트웨이와 라우팅 테이블로 인터넷 경로를 제어하는 구조를 나타낸다. 퍼블릭 서브넷은 IGW로, 프라이빗 서브넷은 NAT 게이트웨이로만 아웃바운드가 나가며, 인스턴스 단위 경계는 보안 그룹이 맡는다.
# terraform: 2-AZ VPC + IGW + NAT + 프라이빗 라우팅
data "aws_availability_zones" "available" {
  state = "available"
}

resource "aws_vpc" "main" {
  cidr_block           = "10.0.0.0/16"
  enable_dns_support   = true
  enable_dns_hostnames = true # EKS/ALB/RDS 엔드포인트에 필수
  tags                 = { Name = "main" }
}

resource "aws_subnet" "public" {
  count             = 2
  vpc_id            = aws_vpc.main.id
  cidr_block        = cidrsubnet(aws_vpc.main.cidr_block, 4, count.index)       # 10.0.0.0/20, 10.0.16.0/20
  availability_zone = data.aws_availability_zones.available.names[count.index]
  tags              = { Name = "public-${count.index}", "kubernetes.io/role/elb" = "1" }
}

resource "aws_subnet" "private" {
  count             = 2
  vpc_id            = aws_vpc.main.id
  cidr_block        = cidrsubnet(aws_vpc.main.cidr_block, 4, count.index + 4)   # 10.0.64.0/20, 10.0.80.0/20
  availability_zone = data.aws_availability_zones.available.names[count.index]
  tags              = { Name = "private-${count.index}", "kubernetes.io/role/internal-elb" = "1" }
}

resource "aws_internet_gateway" "igw" {
  vpc_id = aws_vpc.main.id
}

resource "aws_route_table" "public" {
  vpc_id = aws_vpc.main.id
  route {
    cidr_block = "0.0.0.0/0"
    gateway_id = aws_internet_gateway.igw.id
  }
}

resource "aws_route_table_association" "public" {
  count          = 2
  subnet_id      = aws_subnet.public[count.index].id
  route_table_id = aws_route_table.public.id
}

resource "aws_eip" "nat" {
  domain = "vpc"
}

resource "aws_nat_gateway" "nat" {
  allocation_id = aws_eip.nat.id
  subnet_id     = aws_subnet.public[0].id   # 프로덕션이면 AZ마다 1개
  depends_on    = [aws_internet_gateway.igw]
}

resource "aws_route_table" "private" {
  vpc_id = aws_vpc.main.id
  route {
    cidr_block     = "0.0.0.0/0"
    nat_gateway_id = aws_nat_gateway.nat.id
  }
}

resource "aws_route_table_association" "private" {
  count          = 2
  subnet_id      = aws_subnet.private[count.index].id
  route_table_id = aws_route_table.private.id
}
3.2 보안 그룹(Security Group) vs NACL(Network ACL)
| 항목 | 보안 그룹 | 네트워크 ACL |
|---|---|---|
| 적용 단위 | ENI(인스턴스/서비스) | 서브넷 |
| 상태 | Stateful (응답 자동 허용) | Stateless (양방향 명시 필요) |
| 규칙 | 허용만(Allow), 기본 전부 거부 | 허용+거부, 우선순위 번호 |
| SG 참조 | 다른 SG를 소스로 참조 가능 | 불가, CIDR만 |
| 기본값 | 아웃바운드 전체 허용 | 기본 NACL은 전체 허용 |
실무 규칙: 일상적인 경계는 보안 그룹으로 잡고, NACL은 서브넷 단위 차단(특정 CIDR 스캔 차단, DMZ 격리)에만 쓴다. Gotcha: NACL에 인바운드 443만 열고 아웃바운드 ephemeral 포트(1024-65535)를 안 열면 curl이 연결은 되는데 응답이 안 온다. Stateless라는 사실을 잊으면 디버깅에 몇 시간을 태운다.
4. 컴퓨팅: VM·컨테이너·서버리스
| 축 | VM(EC2/GCE/Azure VM) | 컨테이너(EKS/GKE/AKS, ECS) | 서버리스(Lambda/Cloud Run/Functions) |
|---|---|---|---|
| 과금 단위 | 초(최소 60초), 예약/스팟 할인 | 노드 또는 파드(vCPU·메모리) | 요청 수 + 실행 시간(ms) |
| 시작 지연 | 수십 초(AMI에 따라) | 이미지 풀 시간(수 초~분) | 콜드 스타트 100ms~수 초 |
| 상시 부하 비용 | 가장 저렴(RI/Savings Plan) | 중간 | 가장 비쌈 |
| 운영 부담 | OS 패치 직접 | 제어 평면은 관리형, 워크로드는 직접 | 최소 |
| 실행 상한 | 없음 | 없음 | Lambda 15분, 응답 6MB |
4.1 선택 기준
- 부하 예측 가능 + 상시 > 3개월 → Reserved Instance/Savings Plan + 오토스케일링 그룹.
- 다수 서비스, 오케스트레이션·서비스 메시·배치 스케줄링 필요 → 관리형 K8s.
- 이벤트 스파이크, 아이들 시간 김, 단일 함수 로직 → 서버리스. 단, 15분 초과 작업, 상태 유지 세션, VPC 내 고정 처리량은 부적합.
- 배치/CI 러너/내결함 워크로드 → 스팟(Spot)/선점형. 단, 인스턴스는 2분 통보 후 회수되므로 체크포인트와 graceful shutdown이 필수다.
# 3개 AZ 분산 + IRSA(서비스 어카운트에 IAM 역할 매핑)
apiVersion: v1
kind: ServiceAccount
metadata:
  name: api-sa
  namespace: prod
  annotations:
    eks.amazonaws.com/role-arn: arn:aws:iam::111122223333:role/prod-api-s3-writer
---
apiVersion: apps/v1
kind: Deployment
metadata:
  name: api
  namespace: prod
spec:
  replicas: 6
  selector:
    matchLabels: { app: api }
  strategy:
    rollingUpdate: { maxUnavailable: 0, maxSurge: 1 }
  template:
    metadata:
      labels: { app: api }
    spec:
      serviceAccountName: api-sa
      terminationGracePeriodSeconds: 30
      topologySpreadConstraints:
        - maxSkew: 1
          topologyKey: topology.kubernetes.io/zone
          whenUnsatisfiable: DoNotSchedule
          labelSelector:
            matchLabels: { app: api }
      containers:
        - name: api
          image: 111122223333.dkr.ecr.ap-northeast-2.amazonaws.com/api:1.4.2
          ports: [{ containerPort: 8080 }]
          readinessProbe:
            httpGet: { path: /healthz, port: 8080 }
            periodSeconds: 5
          resources:
            requests: { cpu: "500m", memory: "512Mi" }
            limits:   { memory: "512Mi" }
topologySpreadConstraints는 ReplicaSet 스케줄링 시점에만 평가된다. 노드가 죽어 파드가 밀리면 균형이 깨지므로, kubectl get pods -o wide --sort-by=.spec.nodeName로 주기적으로 확인하고 Descheduler나 클러스터 오토스케일러로 보정한다.
5. 스토리지 분류: 오브젝트·블록·파일
| 유형 | 예 | 접근 방식 | 적합한 용도 |
|---|---|---|---|
| 오브젝트 | S3, GCS, Azure Blob | HTTP API, 키 기반 | 정적 자산, 백업, 데이터 레이크, 로그 |
| 블록 | EBS, Persistent Disk, Managed Disk | 디바이스로 attach, 단일 노드 | DB 데이터 파일, OS 볼륨 |
| 파일 | EFS, FSx, Filestore, Azure Files | NFS/SMB 공유 | 다수 파드 공유 설정, 레거시 앱 |
- S3 내구성 11 nines는 다중 AZ 복제 덕분이다. 단, 버킷 단위가 아니라 객체 단위로 일관성·수명주기를 관리한다. 스토리지 클래스는 접근 패턴으로 고른다: 자주 접근 → Standard, 월 1회 → Standard-IA, 분기 1회 → Glacier Instant Retrieval, 아카이브 → Glacier Deep Archive.
- Gotcha: S3 Intelligent-Tiering은 모니터링 요금이 붙지만 객체가 작고 접근 패턴이 변덕스러우면 이득이다. 반대로 Glacier Deep Archive에 넣은 객체를 복원하면 표준 복원에 12시간이 걸린다. 삭제 대신 수명주기 규칙으로 전환하고, 오브젝트 락/Object Lock이 필요한 규제 데이터는 별도 버킷으로 분리한다.
- EBS vs 인스턴스 스토어: gp3는 기준 3,000 IOPS/125MB/s로 시작해 독립적으로 프로비저닝 가능, io2는 고성능 DB용. 인스턴스 스토어는 인스턴스에 물리적으로 붙어 있어 중지/종료 시 데이터가 사라진다.
# S3: 버킷 정책 최소화 + 수명주기 + 퍼블릭 액세스 전면 차단
aws s3api create-bucket --bucket prod-assets-111122223333 \
  --region ap-northeast-2 --create-bucket-configuration LocationConstraint=ap-northeast-2

aws s3api put-public-access-block --bucket prod-assets-111122223333 \
  --public-access-block-configuration \
  BlockPublicAcls=true,IgnorePublicAcls=true,BlockPublicPolicy=true,RestrictPublicBuckets=true

aws s3api put-bucket-lifecycle-configuration --bucket prod-assets-111122223333 \
  --lifecycle-configuration '{
    "Rules": [{
      "ID": "archive-then-expire",
      "Filter": { "Prefix": "logs/" },
      "Status": "Enabled",
      "Transitions": [
        { "Days": 30,  "StorageClass": "STANDARD_IA" },
        { "Days": 90,  "StorageClass": "GLACIER_IR" }
      ],
      "Expiration": { "Days": 365 },
      "NoncurrentVersionExpiration": { "NoncurrentDays": 30 }
    }]
  }'
6. 관리형 데이터베이스 선택
| 서비스 | 종류 | 강점 | 주의점 |
|---|---|---|---|
| RDS (MySQL/PostgreSQL) | 관계형 | 익숙한 엔진, Multi-AZ 자동 페일오버 | 스토리지/인스턴스 상한, 수직 확장 중심 |
| Aurora | 관계형(분산 스토리지) | 3 AZ 6-way 복제, 리더 최대 15개, 빠른 페일오버 | 일반 RDS 대비 비용 높음, 최소 인스턴스 구성 필요 |
| DynamoDB | 키-값/문서 | 무제한 확장, 한 자릿수 ms, 온디맨드 | 접근 패턴을 먼저 설계, 핫 파티션 취약 |
| ElastiCache (Redis) | 인메모리 | 캐시, 세션, 락, 스트림 | 영속성 옵션 한계, 장애 시 캐시 스탬피드 |
| DocumentDB / Neptune / OpenSearch | 특수 목적 | 문서/그래프/검색 | 각 엔진의 API 제약 |
- Multi-AZ ≠ 읽기 확장: Multi-AZ는 가용성(자동 페일오버) 장치이고, 실제 트래픽을 받지 않는 대기 인스턴스다. 읽기를 늘리려면 읽기 복제본(Read Replica) 이 필요하다. 읽기 복제본은 승격하지 않으면 자동 페일오버 대상이 아니다. Aurora는 리더/라이터가 스토리지를 공유하므로 페일오버가 보통 30초 이내다.
- Gotcha — DynamoDB 핫 파티션: 파티션 키가
status처럼 카디널리티 낮은 값이거나,2026-10-10처럼 날짜 접두사에 트래픽이 몰리면 단일 파티션 처리량(기본 3,000 RCU/1,000 WCU)에서 스로틀링이 난다. 고카디널리티 키(userId+ 샤드 접미사)로 재설계하거나, GSI를 분리하고, 온디맨드 모드의 초기 처리량 한도도 확인한다.
# SNS 팬아웃 → SQS, 그리고 Aurora PostgreSQL 클러스터
TOPIC_ARN=$(aws sns create-topic --name orders --query TopicArn --output text)
QUEUE_URL=$(aws sqs create-queue --queue-name orders-shipping \
  --attributes VisibilityTimeout=60,MessageRetentionPeriod=345600 --query QueueUrl --output text)
QUEUE_ARN=$(aws sqs get-queue-attributes --queue-url "$QUEUE_URL" \
  --attribute-names QueueArn --query 'Attributes.QueueArn' --output text)
aws sns subscribe --topic-arn "$TOPIC_ARN" --protocol sqs --notification-endpoint "$QUEUE_ARN"

aws rds create-db-cluster --db-cluster-identifier app-prod \
  --engine aurora-postgresql --engine-version 16.4 \
  --master-username appadmin --manage-master-user-password \
  --storage-encrypted --backup-retention-period 7

for i in 1 2; do
  aws rds create-db-instance --db-instance-identifier "app-prod-$i" \
    --db-cluster-identifier app-prod --engine aurora-postgresql \
    --db-instance-class db.r6g.large --no-publicly-accessible
done
7. 메시징과 이벤트
| 서비스 | 모델 | 전달 보장 | 전형적 용도 |
|---|---|---|---|
| SQS Standard | 큐(당김) | at-least-once, 순서 보장 없음 | 작업 큐, 버퍼링, 재시도 |
| SQS FIFO | 큐 | exactly-once 처리 + 순서(처리량 제한) | 결제, 순차 명령 |
| SNS | 발행/구독(팬아웃) | at-least-once | 다중 구독자 알림, 팬아웃 |
| EventBridge | 이벤트 버스/규칙 | at-least-once | 서비스 간 라우팅, 스키마 레지스트리, 크론 |
| MSK / Kinesis | 스트림(로그) | 순서 + 리플레이 | CDC, 로그 파이프라인, 실시간 분석 |
- SQS 설계 핵심은 세 값:
VisibilityTimeout(처리 시간보다 충분히 크게),MessageRetentionPeriod,maxReceiveCount+ DLQ(Dead Letter Queue). 처리 실패를 조용히 삼키지 않으려면 DLQ를 항상 붙이고 CloudWatchApproximateNumberOfMessagesVisible알람을 설정한다. - Gotcha:
VisibilityTimeout이 실제 처리 시간보다 짧으면 같은 메시지가 다음 폴러에게 전달되어 중복 처리가 발생한다(스탠다드 큐는 애초에 at-least-once다). 소비자는 반드시 멱등(idempotent) 하게 작성하고, 처리 완료 후 즉시DeleteMessage를 호출한다. Lambda 트리거는 배치 실패 시 부분 배치 응답(ReportBatchItemFailures)을 써서 성공분을 재처리하지 않게 한다. - MSK/Kafka는 파티션 수가 병렬성 상한이다. 파티션 키를 주문 ID로 두면 순서가 보장되지만 핫 파티션 위험이 따르므로, 키 카디널리티와 처리량을 함께 본다.
8. 네트워킹: 로드 밸런서·DNS·CDN
| 계층 | 서비스 | 특징 |
|---|---|---|
| L7 | ALB / GCLB / App Gateway | HTTP 라우팅(호스트·경로·헤더), WAF/ACM 통합, WebSocket |
| L4 | NLB / Network LB | TCP/UDP, 초저지연, 고정 IP, PrivateLink 엔드포인트 |
| L3 | GWLB | 방화벽/IDS 어플라이언스 삽입 |
- ALB: 타깃 그룹별 헬스체크,
slow_start, 스티키 세션은 기본 비활성(비활성 유지 권장 — 파드가 죽으면 세션 고정이 오히려 장애를 늘린다). NLB: 소스 IP 보존, ALB 앞단에 두어 고정 IP + L7을 조합하기도 한다. - Route53: 라우팅 정책으로 Simple / Weighted(카나리) / Latency / Failover / Geolocation / Multi-value를 제공. 별칭(Alias) 레코드는 A/AAAA를 무료로 관리형 리소스에 연결한다. Gotcha: TTL 60초짜리 Failover 레코드는 페일오버 판정까지 몇 분이 걸리므로, 엄격한 SLA는 헬스체크 세부 설정(
FailureThreshold/RequestInterval)과 함께 설계한다. - CloudFront: 캐시 키 정책(쿼리스트링·헤더·쿠키)을 최소화해야 히트율이 오른다. 캐싱을 끄려면 TTL 0으로 두는 대신
Cache-Control을 오리진에서 제어한다. 오리진은 OAC(Origin Access Control) 로 S3를 퍼블릭에서 숨긴다.
9. IAM 기초: 사용자·역할·정책·역할 수임
- 사용자(User) 는 장기 자격 증명이다. 사람에게는 사용자 + MFA, 워크로드에는 역할(Role) 을 준다. CI/CD에 액세스 키를 하드코딩하는 것은 최악의 관행이며, 가능하면 OIDC(GitHub Actions →
sts:AssumeRoleWithWebIdentity)를 쓴다. - 역할 수임(AssumeRole): 신뢰 정책(trust policy)이 “누가 이 역할을 맡을 수 있는가”를, 권한 정책이 “맡은 뒤 무엇을 할 수 있는가”를 정의한다. EC2는 인스턴스 프로파일, EKS는 IRSA 또는 EKS Pod Identity로 파드에 역할을 매핑한다.
- 정책 평가 순서: 명시적
Deny→ SCP → 리소스 기반 정책 → 자격 증명 기반 정책 → 권한 경계(Permissions Boundary) → 세션 정책. 명시적 Deny는 절대 이기지 못한다는 규칙이 가장 중요하다.
{
  "Version": "2012-10-17",
  "Statement": [{
    "Effect": "Allow",
    "Principal": { "AWS": "arn:aws:iam::111122223333:root" },
    "Action": "sts:AssumeRole",
    "Condition": { "StringEquals": { "sts:ExternalId": "ci-pipeline-9f2c" } }
  }]
}
# 외부 ID로 역할 수임 후 임시 자격 증명만 사용 (액세스 키 파일 없음)
CREDS=$(aws sts assume-role \
  --role-arn arn:aws:iam::111122223333:role/ci-deployer \
  --role-session-name "ci-${GITHUB_RUN_ID:-local}" \
  --external-id ci-pipeline-9f2c \
  --duration-seconds 3600 \
  --query Credentials --output json)

export AWS_ACCESS_KEY_ID=$(jq -r .AccessKeyId <<<"$CREDS")
export AWS_SECRET_ACCESS_KEY=$(jq -r .SecretAccessKey <<<"$CREDS")
export AWS_SESSION_TOKEN=$(jq -r .SessionToken <<<"$CREDS")

aws sts get-caller-identity   # Arn이 assumable-role/ci-deployer 인지 확인
Gotcha — 혼동된 대리인(confused deputy): 제3자 계정이나 SaaS가 역할을 수임할 때 ExternalId 없이 Principal을 root로 열어두면, 다른 고객이 당신의 역할을 수임해 리소스에 접근할 수 있다. 가능하면 Principal을 특정 역할 ARN으로 좁히고 Condition으로 aws:SourceArn/ExternalId를 검증한다. 또한 와일드카드 Action: "s3:*" + Resource: "*" 조합은 IAM Access Analyzer와 iam-policy-validation으로 반드시 걸러낸다.
10. 관리형 쿠버네티스 비교: EKS / GKE / AKS
| 항목 | EKS | GKE | AKS |
|---|---|---|---|
| 제어 평면 과금 | 시간당 고정(클러스터당) | Standard는 무료, Autopilot은 파드별 | 무료(Standard) / Uptime SLA 옵션 |
| 노드 옵션 | 관리형 노드 그룹, Karpenter, Fargate | 노드 풀, Autopilot, GKE Autopilot | 노드 풀, Virtual Nodes |
| CNI/네트워킹 | VPC CNI(파드 IP = VPC IP) | Dataplane V2(기본) | Azure CNI / kubenet |
| IAM 통합 | IRSA, EKS Pod Identity | Workload Identity | Workload Identity(Microsoft Entra) |
| 로드밸런서 | AWS Load Balancer Controller | GKE Ingress(GCLB) | Application Gateway Ingress |
| 오토스케일 | HPA/VPA/Karpenter/Cluster Autoscaler | HPA/VPA/Cluster Autoscaler | HPA/VPA/Cluster Autoscaler |
# EKS 접속 후 AZ 분포와 CNI 상태 점검
aws eks update-kubeconfig --name prod-cluster --region ap-northeast-2
kubectl get nodes -L topology.kubernetes.io/zone
kubectl get pods -n kube-system -l k8s-app=aws-node -o wide
kubectl get events -A --field-selector reason=FailedScheduling --sort-by=.lastTimestamp | tail -20
- EKS Gotcha — IP 고갈: VPC CNI는 파드마다 VPC IP를 소비한다.
/24서브넷(251개 IP)에 대형 노드가 붙으면FailedScheduling: no IP addresses available로 파드가 뜨지 않는다. 대응은 서브넷 CIDR 확장,prefix delegation활성화, 또는ENABLE_POD_ENI/보조 CIDR 도입./20이상 프라이빗 서브넷을 처음부터 잡아라. - 버전 지원: 관리형 K8s도 셀프 호스팅과 마찬가지로 버전 EOL이 있다. EKS/GKE/AKS 모두 지원 버전을 지키지 않으면 업그레이드를 강제당하거나 클러스터가 유지보수 모드에 들어간다. 노드 그룹은 제어 평면보다 같은 버전이거나 한 단계 낮게 유지한다.
11. Well-Architected Framework 6기둥
- 운영 우수성(Operational Excellence) — IaC로 배포, 작은 단위로 자주 릴리스, 관측 가능성(로그/메트릭/트레이스)과 런북 유지, 사후 분석을 실행 항목으로 전환.
- 보안(Security) — 최소 권한, 전송·저장 암호화 기본값, 자격 증명 수명 단축, 경계 다중화(네트워크·계정·정책), 위협 탐지 자동화.
- 안정성(Reliability) — 장애 도메인 분리(다중 AZ/리전), 수요 대응 오토스케일링, 백업 복원 훈련, 한도(quota) 관리, 정적 안정성(static stability).
- 성능 효율(Performance Efficiency) — 워크로드에 맞는 리소스 유형 선택(컴퓨팅/스토리지/DB), 캐싱·CDN·엔드포인트로 경로 단축, 신규 서비스·기능 정기 평가.
- 비용 최적화(Cost Optimization) — 소비 모델 선택(RI/SP/스팟/서버리스), 유휴 리소스 제거, 태깅과 쇼백, 데이터 전송·NAT·크로스 AZ 비용 인지.
- 지속 가능성(Sustainability) — 수요에 맞춘 프로비저닝, 관리형·공유 서비스 활용, 데이터 수명주기로 저장량 억제, 리전 선택의 탄소 집약도 고려.
6기둥은 순위가 아니라 트레이드오프 도구다. 예: 단일 리전 Multi-AZ(비용↓, 안정성 중간) vs 멀티 리전 active-active(비용↑, 안정성 최대). 각 결정마다 두 기둥 사이의 균형점을 문서화해 남겨라.
12. 흔한 에러 → 원인 → 해결
| 증상 | 원인 | 해결 |
|---|---|---|
프라이빗 서브넷 인스턴스에서 curl 타임아웃 |
NAT GW 없음 또는 프라이빗 라우팅 테이블 미연결 | AZ별 NAT GW 생성 + 0.0.0.0/0 → nat_gateway_id 라우팅/연결 확인 |
403 AccessDenied (권한 정책은 있는데도) |
SCP·권한 경계·버킷 정책의 명시적 Deny, 또는 KMS 키 정책 누락 | CloudTrail AccessDenied 이벤트의 errorMessage, sts:GetCallerIdentity로 실제 주체 확인 |
EKS 파드 FailedScheduling: no IP addresses available |
VPC CNI IP 고갈 | 서브넷 확장/prefix delegation, 노드당 파드 수 하향 |
DynamoDB ProvisionedThroughputExceededException |
핫 파티션 또는 프로비저닝 부족 | 파티션 키 재설계/샤딩, GSI 분리, 온디맨드 전환 |
| 같은 메시지가 여러 번 처리됨 | VisibilityTimeout < 처리 시간, 멱등성 부재 | VisibilityTimeout 상향(처리시간×3), 컨슈머 멱등 처리, DLQ + maxReceiveCount |
| RDS 장애 시 서비스 중단 | 읽기 복제본을 페일오버 대상으로 오해(Multi-AZ 미적용) | Multi-AZ 활성화 또는 Aurora로 이전, 페일오버 리허설 |
| NACL 인바운드만 열었는데 응답 없음 | NACL은 stateless | 아웃바운드 ephemeral 포트(1024-65535) 허용 |
13. 실무 체크리스트
- VPC CIDR이 온프레미스·타 VPC와 겹치지 않고, AZ별 프라이빗 서브넷에 확장 여유(
/20이상)가 있는가 - 프로덕션 워크로드가 2개 이상 AZ에 분산되고, AZ ID 기준으로 계정 간 배치가 일치하는가
- 프라이빗 서브넷 아웃바운드가 AZ별 NAT GW 또는 VPC 엔드포인트로만 나가며, 인터넷 경로가 의도한 곳에만 열려 있는가
- 보안 그룹에
0.0.0.0/0인바운드가 있는 리소스 목록을 뽑아 설명할 수 있는가(NACL 규칙은 inbound/outbound 짝을 검증했는가) - 사람 계정은 MFA 필수, 워크로드는 역할 기반이며 장기 액세스 키가 코드·CI에 남아 있지 않은가
- 외부 계정이 수임하는 역할에
ExternalId/aws:SourceArn조건과 최소 권한 정책이 걸려 있는가 - 스토리지 암호화(SSE-KMS), 퍼블릭 액세스 차단, 수명주기 규칙이 모든 버킷/볼륨에 적용되어 있는가
- DB는 Multi-AZ 또는 Aurora이고, 백업에서 실제 복원을 최근 90일 내 검증했는가
- 큐/스트림마다 DLQ·재시도 한도·알람이 있고, 컨슈머가 멱등하게 구현되어 있는가
- IaC(Terraform 등)로 프로비저닝되며 드리프트 감지(
terraform plan/Config 규칙)와 태깅 표준이 강제되는가
14. 정리
- 책임 경계는 서비스 모델이 아니라 계층으로 본다. IaaS든 SaaS든 데이터·접근 관리·구성·앱 계층 책임은 고객에게 남는다. “관리형이니 안전하다”는 착각이 가장 비싼 함정이다.
- 장애 허용을 숫자로 고정한다. AZ는 전원·냉각·네트워크가 분리된 도메인이고, N+1 AZ 배치와 AZ ID 기준 정렬이 계정 간 일관성과 크로스 AZ 비용을 좌우한다.
- 네트워크는 라우팅이 정의한다. 퍼블릭/프라이빗은 이름이 아니라 IGW·NAT 경로이고, 경계는 보안 그룹(Stateful)으로 잡고 NACL(Stateless)은 서브넷 차단에만 쓴다.
- 컴퓨팅·스토리지·DB는 부하 형태가 고른다. 상시 부하는 RI/SP, 이벤트 스파이크는 서버리스, 오케스트레이션이 필요하면 관리형 K8s. DB는 Multi-AZ와 읽기 확장을 분리해 설계한다.
- 권한은 역할과 임시 자격 증명으로 준다. 명시적 Deny가 최우선이고, 역할 수임에는 ExternalId·SourceArn 조건을 걸며, 메시징은 DLQ와 멱등 소비자로 중복을 견딘다.
References
- AWS — Shared Responsibility Model
- AWS Documentation — Regions and Availability Zones
- AWS Documentation — What is Amazon VPC
- AWS Documentation — Policy evaluation logic
- AWS Well-Architected — The pillars of the framework
- Microsoft Learn — Shared responsibility in the cloud
댓글남기기