
쿠버네티스 기초: 컨트롤 플레인 아키텍처와 핵심 오브젝트
이 시리즈는 쿠버네티스와 클라우드(AWS·GCP·Azure 공통 개념)를 실무 관점에서 정리한 기록이다. 핵심 개념·코드 예제·실전 함정(gotcha) 중심으로, 학습과 설계 리뷰·장애 대응에 바로 쓸 수 있게 구성했다. 각 편은 독립적으로 읽을 수 있고, 순서대로 보면 클러스터 내부 구조에서 클라우드 운영까지 하나의 흐름으로 이어진다.
쿠버네티스(Kubernetes)는 컨테이너화된 워크로드를 여러 노드에 걸쳐 선언적으로 배포·확장·복구하는 오케스트레이터다. 이번 편에서는 앞서 정리해 둔 쿠버네티스 기초 노트를 업스트림(upstream) 기준으로 다시 정리하면서, 클러스터를 구성하는 컴포넌트와 그 사이의 인터페이스(CRI, 조정 루프), 실무에서 매일 쓰는 핵심 오브젝트·명령, 그리고 버전 정책과 업그레이드 전략을 한 번에 다룬다. 특정 배포판보다 업스트림 개념을 기준으로 설명하되, 관리형 서비스(EKS/GKE/AKS)와의 차이는 별도로 표시한다. 다음 편인 쿠버네티스 워크로드에서 Pod·Deployment·StatefulSet·Job과 오토스케일링을 이어서 살펴본다.
- 컨테이너와 VM의 격리 경계 차이, 언제 무엇을 고를지 판단 기준을 세운다
- 컨트롤 플레인·워커 노드 컴포넌트와 그 사이의 인터페이스를 한 그림으로 엮는다
- 선언적 모델과 조정 루프(observe → diff → act)의 동작 원리를 이해한다
- 레이블·어노테이션·파이널라이저 같은 핵심 오브젝트의 역할과 함정을 구분한다
- kubectl 실전 명령과 업그레이드 스큐 정책, 실전 함정·체크리스트를 정리한다
1. 컨테이너(Container)와 가상 머신(VM)의 차이
가상 머신(VM, Virtual Machine)은 하이퍼바이저 위에 게스트 커널을 포함한 OS 전체를 올린다. 컨테이너는 호스트 커널을 공유하고 리눅스 네임스페이스(namespace)로 격리, cgroup으로 자원을 제한한다. 이미지에는 앱과 의존성만 들어가므로 크기와 기동 시간이 한 자릿수 이상 차이 난다.
| 구분 | 컨테이너 | VM |
|---|---|---|
| 기동 시간 | 수백 ms ~ 수 초 | 수십 초 ~ 분 |
| 이미지 크기 | 앱 + 의존성 (MB 단위) | OS 전체 (GB 단위) |
| 커널 | 호스트 커널 공유 | 게스트 커널 별도 |
| 격리 경계 | 프로세스 수준 (namespace/cgroup) | 하드웨어 가상화 |
| 노드당 밀도 | 수십 ~ 수백 | 수 ~ 수십 |
| 전형적 상태 | 무상태 + 불변 이미지 | 장기 실행 + 스냅샷 |
- 격리 강도가 다르다. 컨테이너는 커널 취약점이 곧 탈출 경로가 되므로, 신뢰 경계가 다른 테넌트를 섞을 때는 전용 노드·VM, seccomp/AppArmor, 샌드박스 런타임(gVisor, Kata Containers)을 검토한다.
- 실무 판단 기준: 다중 테넌트·강한 격리가 필요하면 VM 또는 전용 노드 풀, 일반 마이크로서비스는 컨테이너가 비용·밀도 면에서 유리하다.
- 두 모델은 배타적이지 않다. 관리형 쿠버네티스 노드 자체가 VM이고, 그 위에서 컨테이너가 돈다.
2. 쿠버네티스가 해결하는 문제
컨테이너 런타임만으로는 “어느 노드에 띄울 것인가”, “죽으면 누가 살릴 것인가”를 답할 수 없다. 쿠버네티스가 담당하는 범위는 다음과 같다.
- 스케줄링/배치: 자원 요청(request) 기반 배치, nodeSelector·affinity·taint/toleration으로 물리적 제약 표현.
- 자가 치유(self-healing): 컨테이너 프로세스 재시작, 파드 재생성, 노드 이탈 시 다른 노드로 재배치.
- 수평 확장/롤아웃: HPA(Horizontal Pod Autoscaler), Deployment의 롤링 업데이트와 롤백.
- 서비스 디스커버리와 로드밸런싱: Service, EndpointSlice, CoreDNS를 통한 안정적 가상 IP와 DNS 이름.
- 설정/비밀 주입: ConfigMap, Secret을 볼륨 또는 환경변수로 주입해 이미지 불변성 유지.
- 선언적 수렴: 원하는 상태(desired state)를 기술하면 조정 루프(reconciliation loop)가 현재 상태를 맞춘다.
- 스토리지·정책 추상화: PV/PVC/CSI, RBAC, NetworkPolicy, ResourceQuota.
해결하지 않는 것도 명확히 알아야 한다. CI(빌드), 로그/메트릭 영구 저장소, 애플리케이션 코드의 멱등성, 데이터베이스 일관성은 쿠버네티스의 책임이 아니다. 이 경계를 착각하면 “쿠버네티스가 해주겠지”라는 잘못된 설계로 이어진다.
3. 클러스터 아키텍처
클러스터는 요청을 해석하는 컨트롤 플레인과 실제 워크로드가 도는 워커 노드로 나뉜다. 두 영역의 컴포넌트와 그 사이를 오가는 흐름을 먼저 한 장으로 잡고 들어가면 이후 개념이 훨씬 수월하다.
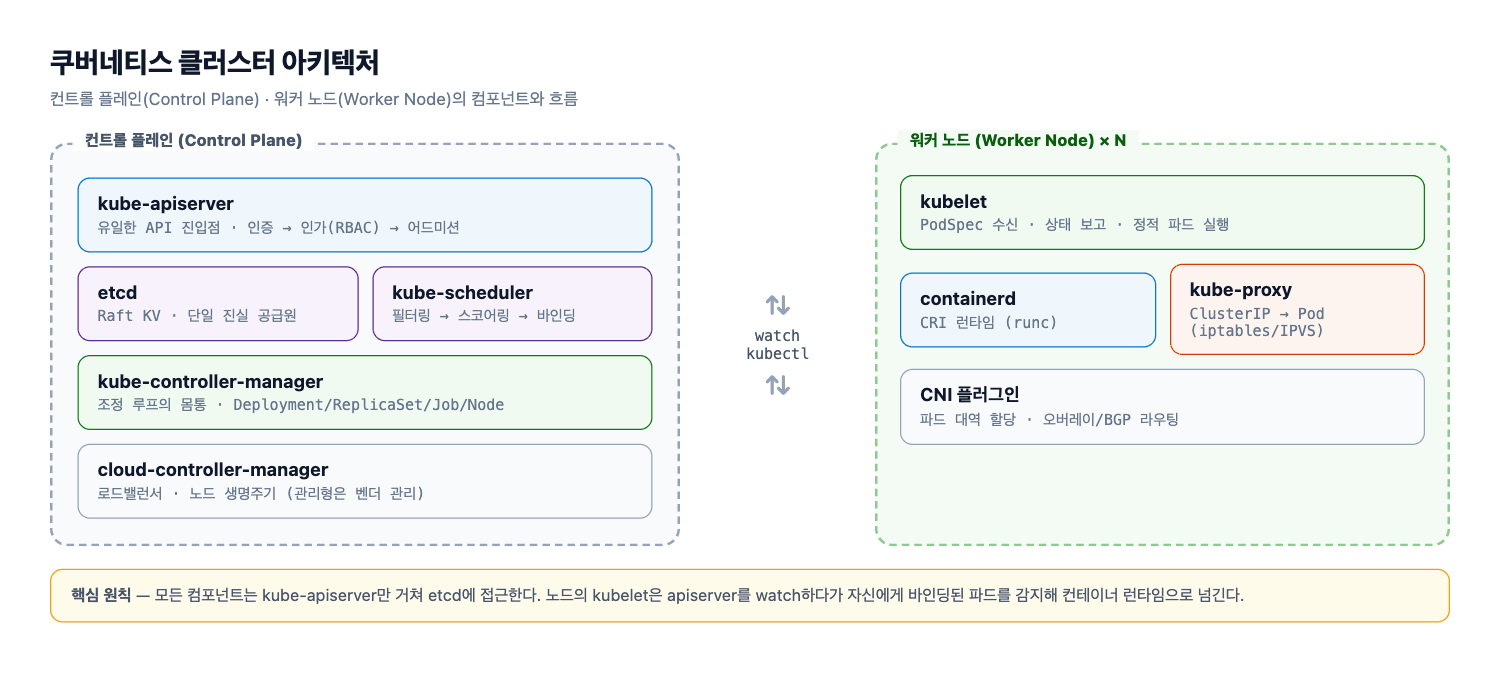
위 다이어그램은 컨트롤 플레인의 네 컴포넌트(kube-apiserver·etcd·kube-scheduler·kube-controller-manager)와 워커 노드의 런타임 구성(kubelet·containerd·kube-proxy·CNI)이 어떻게 연결되는지 보여준다. 모든 컴포넌트는 kube-apiserver만 거쳐 etcd에 접근하고, kubelet은 apiserver를 watch하다가 자신에게 바인딩된 파드를 런타임으로 넘긴다.
3.1 컨트롤 플레인(Control Plane)
| 컴포넌트 | 역할 | 주의점 |
|---|---|---|
| kube-apiserver | 유일한 API 진입점. 인증→인가(RBAC)→어드미션 순서로 요청 검증 | 모든 컴포넌트가 여기만 거쳐 etcd에 접근 |
| etcd | Raft 기반 키-값 저장소, 클러스터의 단일 진실 공급원 | 홀수 쿼럼(3/5), fsync 지연에 민감 |
| kube-scheduler | 바인딩 안 된 파드를 노드에 할당(필터링→스코어링→바인딩) | 자원 여유, 테인트, 어피니티를 종합 |
| kube-controller-manager | Deployment/ReplicaSet/Job/Node 등 다수 컨트롤러를 한 바이너리에서 실행 | 조정 루프의 실제 몸통 |
| cloud-controller-manager | 클라우드 API 연동(로드밸런서, 노드 생명주기) | 관리형에서는 벤더가 관리 |
- etcd가 가장 먼저 병목이 된다. SSD에 올리고 쓰기 p99 지연을 10ms 이하로 유지하며,
etcdctl snapshot save로 정기 백업한다. 쿼럼을 잃으면 클러스터는 읽기 전용으로 멈춘다. - 고가용성(HA): apiserver 3대 이상 + L4 로드밸런서, etcd 3/5대. kubeadm은 stacked etcd(컨트롤 플레인과 동거)와 external etcd(분리) 두 구성을 지원한다. 규모와 격리 요구가 크면 external을 쓴다.
- 관리형 서비스에서는 컨트롤 플레인 접근이 API 엔드포인트로 제한되고, etcd는 직접 접근할 수 없다(백업도 벤더 책임 범위).
3.2 워커 노드(Worker Node)
- kubelet: 노드 에이전트. apiserver로부터 PodSpec을 받아 컨테이너 런타임에 전달하고, 컨테이너 상태를 주기적으로 보고한다. kubeadm 환경에서 컨트롤 플레인 컴포넌트 자체도
/etc/kubernetes/manifests의 정적 파드(static pod)로 kubelet이 띄운다. - 컨테이너 런타임(container runtime): CRI(Container Runtime Interface)를 구현한 프로세스. 사실상 표준은 containerd이며 CRI-O도 쓰인다. 저수준 런타임으로 runc가 있고, 격리를 강화하려면 Kata/gVisor 같은 샌드박스 런타임을 고른다. dockershim은 1.24에서 제거되었으므로 “도커가 런타임”이라는 설명은 더 이상 유효하지 않다.
- kube-proxy: Service의 가상 IP(ClusterIP)를 실제 백엔드 파드로 변환한다. 기본은 iptables 모드이며, IPVS 모드는 대규모 서비스에서 성능이 낫다. 최근에는 eBPF 기반 CNI(Cilium 등)가 kube-proxy를 대체하기도 한다.
- CNI 플러그인: 파드 네트워크 대역 할당과 라우팅. 노드마다 다른 CIDR을 갖고, 터널 오버레이 또는 BGP로 연결한다.
- 그 외 노드 구성: cgroup v2, device plugin, CSI 노드 드라이버, container runtime의 이미지 저장소 디렉터리 용량.
4. 선언적 모델과 조정 루프(Reconciliation Loop)
명령적(imperative) 방식은 “컨테이너 3개 띄워라”라고 지시한다. 선언적(declarative) 방식은 “레플리카 3개를 유지하라”는 상태를 기술하고, 컨트롤러가 현재 상태를 반복 관찰해 차이를 좁힌다. 이 루프는 관찰(observe) → 비교(diff) → 조치(act) 세 단계의 무한 반복이다.
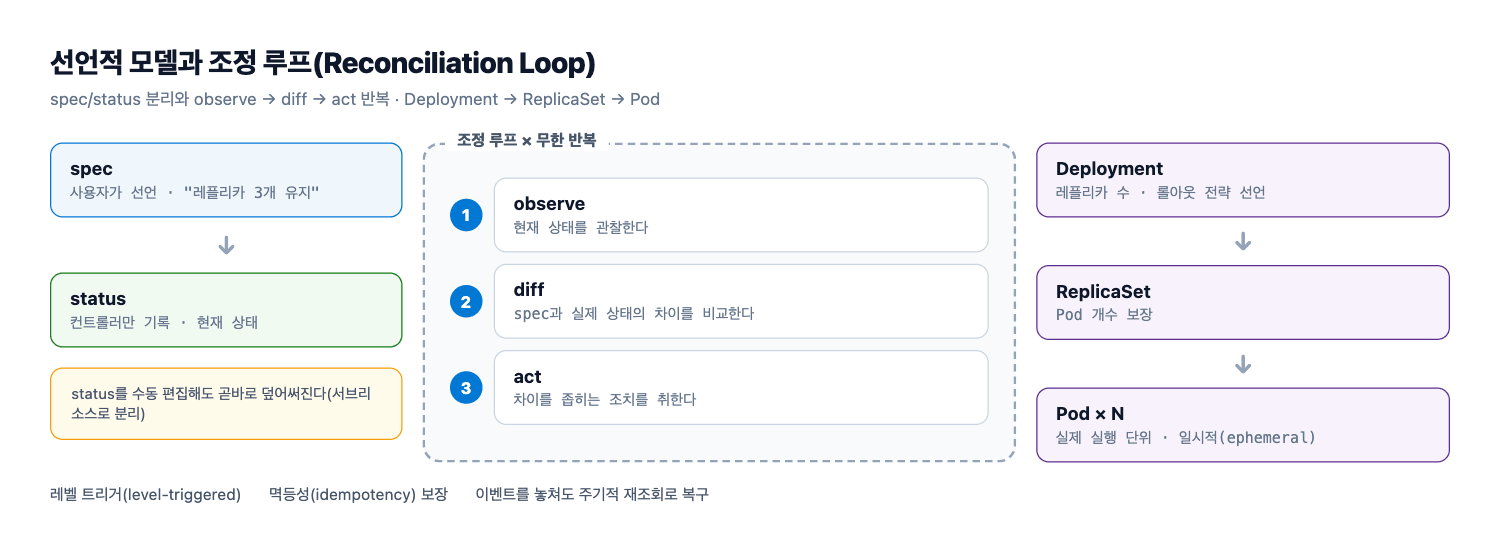
위 그림은 사용자가 쓰는 spec과 컨트롤러만 기록하는 status의 분리, observe → diff → act로 이어지는 조정 루프, 그리고 Deployment → ReplicaSet → Pod로 내려가는 소유 관계를 함께 나타낸다. 컨트롤러는 이 세 단계를 끝없이 반복하며 선언된 상태로 수렴시킨다.
- 멱등성(idempotency): 같은 조치를 두 번 적용해도 결과가 같아야 한다. 컨트롤러는 이벤트를 놓쳐도 주기적 재조회로 복구하므로 레벨 트리거(level-triggered) 방식으로 동작한다.
- spec/status 분리: 사용자는
spec만 쓰고status는 컨트롤러만 쓴다.status를 수동 편집해도 대개 곧바로 덮어써진다(서브리소스로 분리된 필드). - kubectl apply는 상태를 선언한다. 서버 사이드 어플라이(server-side apply)와 필드 관리자(field manager) 충돌을 이해해야 다중 운영자 환경에서 안전하다.
apiVersion: v1
kind: Namespace
metadata:
  name: payments
  labels:
    team: fintech
    pod-security.kubernetes.io/enforce: restricted
---
apiVersion: apps/v1
kind: Deployment
metadata:
  name: checkout
  namespace: payments
  labels:
    app.kubernetes.io/name: checkout
    app.kubernetes.io/version: "1.4.2"
  annotations:
    kubernetes.io/change-cause: "bump image to 1.4.2"
spec:
  replicas: 3
  selector:
    matchLabels:
      app.kubernetes.io/name: checkout
  strategy:
    type: RollingUpdate
    rollingUpdate:
      maxSurge: 1
      maxUnavailable: 0
  template:
    metadata:
      labels:
        app.kubernetes.io/name: checkout
    spec:
      terminationGracePeriodSeconds: 30
      containers:
        - name: app
          image: registry.example.com/payments/checkout:1.4.2
          ports:
            - containerPort: 8080
          resources:
            requests:
              cpu: 200m
              memory: 256Mi
            limits:
              memory: 512Mi
          readinessProbe:
            httpGet:
              path: /readyz
              port: 8080
            initialDelaySeconds: 5
          livenessProbe:
            httpGet:
              path: /healthz
              port: 8080
            periodSeconds: 10
5. 핵심 오브젝트
5.1 파드(Pod)
파드는 쿠버네티스의 최소 배포 단위이며, 하나 이상의 컨테이너가 네트워크 네임스페이스와 볼륨을 공유하는 묶음이다. 파드는 일시적(ephemeral) 이다. 죽으면 새 파드가 새 IP로 뜨므로, 단독 파드를 만들지 않고 Deployment·StatefulSet·DaemonSet·Job 같은 워크로드 컨트롤러로 관리한다. 파드 내부에는 init 컨테이너(순차 실행), 사이드카(sidecar) 컨테이너가 들어갈 수 있다.
- restartPolicy(
Always/OnFailure/Never)에 따라 재시작 정책이 달라진다. - QoS 클래스는 requests/limits 조합으로 결정된다(
Guaranteed/Burstable/BestEffort). 노드 자원 압박 시 축출(eviction) 순서에 영향을 준다. - 프로브는 세 종류다.
readinessProbe는 트래픽 투입 여부,livenessProbe는 컨테이너 재시작,startupProbe는 느린 기동 앱 보호. - 종료 시퀀스: SIGTERM →
terminationGracePeriodSeconds대기 → SIGKILL. PID 1이 SIGTERM을 처리하지 않는 앱은 항상 유예 시간을 꽉 채우고 죽으므로,exec형태 진입점 또는 신호 처리를 명시해야 한다.
5.2 네임스페이스(Namespace)
네임스페이스는 리소스 이름의 범위이자 RBAC·ResourceQuota·LimitRange의 경계다. 모든 리소스가 네임스페이스에 속하는 것은 아니다. Node, PersistentVolume, StorageClass, CRD, ClusterRole 같은 클러스터 범위(cluster-scoped) 리소스는 네임스페이스에 존재하지 않는다. default 네임스페이스를 운영 워크로드에 그대로 쓰면 정책 적용이 어려워지므로 팀/서비스 단위로 분리한다.
5.3 레이블(Label)과 셀렉터(Selector)
레이블은 오브젝트를 그룹핑·조회하는 키-값 쌍이고, 셀렉터는 그룹을 선택하는 질의다. Deployment→ReplicaSet→Pod, Service→EndpointSlice, NetworkPolicy→Pod 등 거의 모든 연결이 레이블 셀렉터로 이뤄진다. 즉 레이블은 사실상 인터페이스 계약이다. 키/값은 63자 이하, 영숫자로 시작하고 끝나야 한다.
- 동등성 기반(equality):
app=checkout,tier!=canary - 집합 기반(set-based):
tier in (web,api),env notin (dev,staging),!canary matchLabels(동등성)와matchExpressions(집합 기반)는 Deployment/Service 스펙에서 함께 쓰인다.
# 동등성 vs 집합 기반 셀렉터
kubectl get pods -n payments -l 'app.kubernetes.io/name=checkout,app.kubernetes.io/version!=1.4.1'
kubectl get pods -n payments -l 'tier in (web,api),!canary'

# 셀렉터가 어떤 파드를 실제로 집어가는지(Service→EndpointSlice) 확인
kubectl get endpointslice -n payments -l kubernetes.io/service-name=checkout -o wide
5.4 어노테이션(Annotation)
어노테이션은 셀렉터로 조회할 수 없는 비식별 메타데이터다. 툴과 컨트롤러 설정, 감사 정보, 연락처 같은 값을 담는다. 총 크기 제한(256KB)이 있고, kubectl.kubernetes.io/last-applied-configuration, kubectl.kubernetes.io/change-cause, prometheus.io/scrape, Ingress 클래스 지정 등이 대표 예다. 레이블과 혼동하면 안 되는 이유: 레이블은 인덱싱되어 셀렉터 성능이 보장되지만 어노테이션은 그렇지 않고, 값 길이 제약도 다르다.
5.5 파이널라이저(Finalizer)
파이널라이저는 삭제를 지연시키는 장치다. 오브젝트에 metadata.finalizers 항목이 있으면, 삭제 요청을 받아도 deletionTimestamp만 기록되고 목록이 빌 때까지 실제로 사라지지 않는다. 주로 외부 리소스 정리(클라우드 로드밸런서, DNS 레코드, 외부 볼륨)에 쓰인다.
apiVersion: v1
kind: Pod
metadata:
  name: batch-import
  namespace: payments
  labels:
    app: batch-import
    tier: job
  annotations:
    owner: platform-team@example.com
    description: 월말 정산 1회성 배치
  finalizers:
    - example.com/cleanup-external-lb
spec:
  restartPolicy: Never
  nodeSelector:
    kubernetes.io/os: linux
    workload: batch
  tolerations:
    - key: workload
      operator: Equal
      value: batch
      effect: NoSchedule
  containers:
    - name: importer
      image: registry.example.com/payments/importer:2.0.0
      command: ["/bin/sh", "-c"]
      args: ["/app/import --once"]
# finalizer가 남아 Terminating에 멈춘 파드: 원인 컨트롤러를 먼저 복구한 뒤에만 해제
kubectl get pod batch-import -n payments -o jsonpath='{.metadata.finalizers}{"\n"}'
kubectl patch pod batch-import -n payments --type=merge -p '{"metadata":{"finalizers":[]}}'
6. kubeconfig와 kubectl 필수 명령
kubeconfig는 세 부분으로 나뉜다. clusters(API 서버 주소와 CA), users(자격증명), contexts(클러스터+유저+기본 네임스페이스 조합). KUBECONFIG에 콜론으로 여러 파일을 나열하면 병합된다. users는 대개 exec 플러그인으로 단기 토큰을 발급받는다(aws eks get-token, gke-gcloud-auth-plugin, kubelogin).
# 컨텍스트 병합/전환과 기본 네임스페이스 고정
export KUBECONFIG=~/.kube/config:~/.kube/eks-prod.yaml
kubectl config get-contexts
kubectl config use-context eks-prod
kubectl config set-context --current --namespace=payments

# 조회: 노드/파드/워크로드/k8s 오브젝트
kubectl get nodes -o wide
kubectl get pods -A -o wide --field-selector spec.nodeName=ip-10-0-1-23
kubectl get deploy,rs,pod -n payments -l app.kubernetes.io/name=checkout

# 진단: describe → logs → exec 순으로 좁혀간다
kubectl describe pod checkout-7d9f4c8b6-x2k9p -n payments
kubectl logs -f deploy/checkout -n payments --tail=100 --timestamps
kubectl logs checkout-7d9f4c8b6-x2k9p -n payments --previous
kubectl exec -it checkout-7d9f4c8b6-x2k9p -n payments -- sh
kubectl get events -A --sort-by=.lastTimestamp

# 변경: diff → apply → rollout 확인/롤백
kubectl diff -f ./manifests
kubectl apply -f ./manifests --server-side
kubectl rollout status deploy/checkout -n payments
kubectl rollout undo deploy/checkout -n payments --to-revision=3

# 스펙 문서, 권한 확인, 노드 유지보수
kubectl explain pod.spec.containers.resources
kubectl auth can-i delete pods --as=system:serviceaccount:payments:ci
kubectl cordon node-1 && kubectl drain node-1 --ignore-daemonsets --delete-emptydir-data
kubectl uncordon node-1
7. 클러스터 구성 옵션
| 방식 | 적합한 상황 | 특징 |
|---|---|---|
| kubeadm | 온프레미스/자체 관리, 업스트림 표준 학습 | 컨트롤 플레인을 정적 파드로 부트스트랩, 업그레이드·인증서·etcd를 직접 운영 |
| kind | CI 파이프라인, 로컬 통합 테스트 | 도커 컨테이너 안에 노드를 만들어 멀티 노드 토폴로지까지 재현 |
| minikube | 개인 학습, 빠른 프로토타이핑 | VM/드라이버 기반, 애드온과 대시보드 편의 기능 제공 |
| EKS / GKE / AKS | 프로덕션 | 컨트롤 플레인·etcd 패치 자동, 노드는 노드 그룹 또는 서버리스(Karpenter, Autopilot 등) |
# kind로 멀티 노드 로컬 클러스터 생성 (특정 k8s 버전 고정)
cat <<'EOF' > kind-cluster.yaml
kind: Cluster
apiVersion: kind.x-k8s.io/v1alpha4
nodes:
  - role: control-plane
  - role: worker
  - role: worker
EOF

kind create cluster --name demo --image kindest/node:v1.31.4 --config kind-cluster.yaml
kubectl cluster-info --context kind-demo
# 관리형(EKS) 예: Terraform으로 노드 그룹까지 선언
module "eks" {
  source  = "terraform-aws-modules/eks/aws"
  version = "~> 20.24"

  cluster_name    = "prod-eks"
  cluster_version = "1.31"

  vpc_id     = module.vpc.vpc_id
  subnet_ids = module.vpc.private_subnets

  cluster_endpoint_public_access = false

  eks_managed_node_groups = {
    general = {
      ami_type       = "AL2023_x86_64_STANDARD"
      instance_types = ["m6i.large"]
      min_size       = 3
      max_size       = 9
      desired_size   = 3

      update_config = {
        max_unavailable_percentage = 33
      }
    }
  }

  enable_irsa = true # IAM Roles for Service Accounts
}
8. 버전 지원 정책과 업그레이드 전략
쿠버네티스는 v1.31.4처럼 메이저.마이너.패치로 버전을 매기며, 마이너가 기능 경계, 패치가 버그·보안 수정이다. 업스트림은 연 3회(약 4개월 주기) 마이너를 릴리스하고, 최신 3개 마이너를 지원한다. 각 마이너의 유지 기간은 약 14개월(패치 릴리스는 약 12개월)이다.
| 구성 요소 | 허용 버전 스큐(skew) |
|---|---|
| kubectl | kube-apiserver 대비 ±1 마이너 |
| kubelet | apiserver보다 높을 수 없음, 최대 3 마이너 낮음 |
| kube-controller-manager / kube-scheduler | apiserver보다 높을 수 없음, 최대 1 마이너 낮음 |
| kube-proxy | 노드의 kubelet과 동일하게 유지 권장 |
- 관리형 정책: EKS는 각 버전에 대해 통상 14개월 표준 지원 + 유료 연장 지원을 제공하고, GKE는 릴리스 채널(rapid/regular/stable)로 자동 업그레이드를 관리하며, AKS는 커뮤니티 EOL 이후 일정 기간 플랫폼 지원을 유지한다. 정확한 EOL 날짜는 항상 각 벤더의 릴리스 캘린더에서 확인한다.
- 한 번에 한 마이너만 올린다. 1.29 → 1.31 건너뛰기는 지원되지 않는다.
- 순서: 컨트롤 플레인 → 워커 노드. 컨트롤 플레인을 먼저 올려야 스큐 정책 안에 들어온다.
- 사전 점검: 제거된 API 사용 여부를 스캔한다(
pluto detect,kubent,kubectl get --raw /metrics기반 대시보드,kubectl convert로 매니페스트 변환).extensions/v1beta1같은 옛 그룹은 이미 동작하지 않는다. - 무중단 조건: PodDisruptionBudget,
maxUnavailable: 0+maxSurge: 1, 노드를 한 대씩 처리, 관리형이면 서지 업그레이드(surge upgrade)나 블루/그린 노드풀 교체.
# kubeadm 컨트롤 플레인 1.30 → 1.31 (노드마다 반복)
sudo kubeadm upgrade plan
sudo apt-mark unhold kubeadm && sudo apt-get install -y kubeadm=1.31.4-1.1
sudo kubeadm upgrade apply v1.31.4

# 워커 노드: 드레인 → kubelet/kubectl 교체 → 언코든
kubectl drain node-1 --ignore-daemonsets --delete-emptydir-data
sudo apt-mark unhold kubelet kubectl && sudo apt-get install -y kubelet=1.31.4-1.1 kubectl=1.31.4-1.1
sudo systemctl daemon-reload && sudo systemctl restart kubelet
kubectl uncordon node-1

# 업그레이드 전 필수: etcd 스냅샷
sudo ETCDCTL_API=3 etcdctl snapshot save /backup/etcd-$(date +%F-%H%M).db \
  --endpoints=https://127.0.0.1:2379 \
  --cacert=/etc/kubernetes/pki/etcd/ca.crt \
  --cert=/etc/kubernetes/pki/etcd/server.crt \
  --key=/etc/kubernetes/pki/etcd/server.key
9. 실전 함정과 흔한 에러
| 증상 | 원인 | 해결 |
|---|---|---|
ImagePullBackOff / ErrImagePull |
태그 오타, 사설 레지스트리 자격증명 미설정, 노드에서 레지스트리 도달 불가 | imagePullSecrets 설정, 노드의 DNS/프록시·NAT 경로 점검 |
CrashLoopBackOff (exit 1) |
앱 시작 실패, ConfigMap/Secret 누락, 잘못된 command/args | kubectl logs --previous, 설정 참조 이름 확인 |
OOMKilled (exit 137) |
limits.memory 초과 |
requests/limits 재산정, 메모리 누수 프로파일링 |
Pending — 0/3 nodes are available: Insufficient cpu |
requests 총합이 노드 가용량 초과 | requests 축소 또는 노드 증설(Cluster Autoscaler) |
Pending — had taint ... that the pod didn't tolerate |
테인트된 노드에 스케줄 시도 | toleration 추가 또는 nodeSelector/affinity로 대상 노드 제한 |
파드가 Terminating에서 멈춤 |
finalizer를 처리할 컨트롤러가 죽었거나 권한 상실 | 원인 컨트롤러 복구 후 finalizer 제거(강제 제거는 외부 리소스 누수 위험) |
FailedCreatePodSandBox / 런타임 오류 |
노드 디스크 부족(DiskPressure), containerd 비정상 | 이미지 GC, journalctl -u containerd, 서비스 재시작 |
노드 NotReady |
kubelet 정지, CNI 장애, 인증서 만료 | journalctl -u kubelet, kubectl get csr, 인증서 회전 |
forbidden: User ... cannot ... |
RBAC Role/RoleBinding 누락, 잘못된 ServiceAccount | kubectl auth can-i --as=...로 재현 후 최소 권한 부여 |
no matches for kind ... in version ... |
해당 API 버전이 제거되었거나 CRD 미설치 | kubectl api-resources, kubectl explain으로 확인 후 매니페스트 갱신 |
자주 놓치는 함정:
latest태그 금지. 불변 태그나 다이제스처(@sha256:)를 써야 롤아웃이 결정적이다.- requests 없이 limits만 지정하면 스케줄러가 실제 사용량을 모르고 배치가 왜곡되며, HPA도 부정확해진다(HPA는 requests 대비 사용률로 계산).
- 어노테이션은 셀렉터로 조회할 수 없다. 그룹핑이 필요하면 레이블이다.
- etcd는 홀수 쿼럼이어야 한다. 2대로 구성하면 장애 시 자동 복구가 불가능하다.
- 네임스페이스 삭제로 클러스터 범위 리소스는 지워지지 않는다 (PV, CRD, ClusterRole 등).
- 노드 자원은 노드 위에 뜬 파드들이 나눠 쓴다. 데몬셋과 시스템 예약(system-reserved, kube-reserved)을 반영해 requests를 산정해야 한다.
10. 실무 체크리스트
- 모든 워크로드는 Deployment/StatefulSet 등 컨트롤러로 관리하고, 단독 파드는 디버깅 용도로만 쓴다.
- 컨테이너 이미지 태그를 불변 다이제스처로 고정하고, 사설 레지스트리면
imagePullSecrets를 명시했다. - 모든 컨테이너에 CPU/메모리 requests를 설정하고, HPA 대상은 requests 기준으로 검증했다.
- readiness/liveness/startup 프로브가 실제 엔드포인트와 임계값으로 정의되어 있다.
- 레이블 규약(
app.kubernetes.io/*등)을 팀 표준으로 정하고, 셀렉터·어노테이션 용도를 구분해 문서화했다. - 운영 워크로드는
default네임스페이스에서 분리하고, ResourceQuota·LimitRange·Pod Security를 적용했다. - kubeconfig 컨텍스트와 기본 네임스페이스를 명시적으로 고정하고, 프로덕션 접근은 단기 토큰(exec 플러그인)으로 발급한다.
- 컨트롤 플레인은 HA(apiserver 3+, etcd 홀수), etcd 스냅샷 백업과 복구 리허설이 있다.
- 클러스터 버전이 지원 기간 내에 있고, 제거 예정 API 스캔을 CI에서 수행한다.
- 업그레이드 절차(한 마이너씩, 컨트롤 플레인→노드, PDB/drain 순서)를 런북으로 문서화하고 최근 1회 리허설했다.
11. 정리
- 경계를 먼저 안다. 컨테이너는 호스트 커널을 공유하고 VM은 게스트 커널을 따로 둔다. 격리 요구가 다중 테넌트로 올라가면 VM·샌드박스 런타임을 다시 고려한다.
- apiserver가 유일한 관문이다. 모든 컴포넌트는 kube-apiserver를 거쳐 etcd에 접근하고, etcd는 홀수 쿼럼과 정기 스냅샷으로 지킨다.
- 선언하고 수렴시킨다. spec은 사용자가, status는 컨트롤러가 쓴다. observe → diff → act 루프가 레벨 트리거·멱등성으로 상태를 맞춘다.
- 레이블은 인터페이스다. Deployment→ReplicaSet→Pod, Service→EndpointSlice 연결이 모두 셀렉터로 이뤄지므로, 레이블 규약과 어노테이션 용도를 분리해 둔다.
- 업그레이드는 한 마이너씩. 컨트롤 플레인을 먼저, 노드를 나중에, 스큐 정책 안에서 etcd 스냅샷과 PDB를 준비한다.
References
- Kubernetes Documentation — Cluster Architecture
- Kubernetes Documentation — Containers (CRI, containerd, dockershim 제거)
- Kubernetes Documentation — Objects In Kubernetes (spec/status, 레이블·어노테이션·파이널라이저)
- Kubernetes Documentation — kubectl Reference
- Kubernetes Releases — Version Skew Policy
- Kubernetes Documentation — Upgrading kubeadm clusters
댓글남기기