
쿠버네티스 관찰성과 디버깅: 메트릭·로그·트레이싱과 kubectl 실전
이 시리즈는 쿠버네티스와 클라우드(AWS·GCP·Azure 공통 개념)를 실무 관점에서 정리한 기록이다. 핵심 개념·코드 예제·실전 함정(gotcha) 중심으로, 학습과 설계 리뷰·장애 대응에 바로 쓸 수 있게 구성했다. 각 편은 독립적으로 읽을 수 있고, 순서대로 보면 클러스터 내부 구조에서 클라우드 운영까지 하나의 흐름으로 이어진다.
쿠버네티스(Kubernetes) 운영에서 “무엇이 느린가”와 “왜 죽었는가”를 답하는 능력은 배포 자동화보다 훨씬 값비싼 자산이다. 컨테이너는 불변이며 파드(Pod)는 언제든 다른 노드에서 재생성되므로, 애플리케이션 내부에 SSH로 들어가 로그 파일을 뒤지는 방식은 성립하지 않는다. 이번 편에서는 쿠버네티스 보안에서 세운 경계 위에서 관찰성(observability)의 메트릭(Metrics)·로그(Logs)·트레이스(Traces) 세 축을 수집 경로와 함께 설계하고, 장애 시점에는 kubectl의 결정적 워크플로로 좁혀 들어가는 실천을 다룬다. 각 축의 표준 구성과 실제 진단 절차, 대표 장애 유형별 원인→해결 매핑까지 정리하며, 클러스터 밖으로 나가는 로그·트레이스의 종착지는 클라우드 기초에서 다룬 오브젝트 스토리지·관리형 서비스와 맞물린다.
- 관찰성 3축의 역할 분담과 카디널리티(cardinality) 관리 원칙을 세운다
- metrics-server·Prometheus Operator·ServiceMonitor·PromQL로 메트릭 수집과 알림을 구성한다
- Loki/EFK 로깅과 OpenTelemetry 분산 트레이싱의 수집·샘플링 경로를 정리한다
kubectlget → describe → logs → exec → events 워크플로로 증상을 좁힌다- Pending·CrashLoopBackOff·OOMKilled 같은 대표 장애의 원인→해결과 실무 체크리스트를 정리한다
1. 관찰성 3축 — 무엇을 어디에 쓰는가
세 축은 대체 관계가 아니라 질문의 종류가 다르다. 장애 대응은 보통 메트릭으로 감지 → 트레이스로 구간 특정 → 로그로 원인 확정 순서로 좁혀진다. 그래서 각 축을 어디서 수집해 어디로 보내는지를 먼저 한 장으로 잡고 들어가면 이후 설정이 훨씬 수월하다.
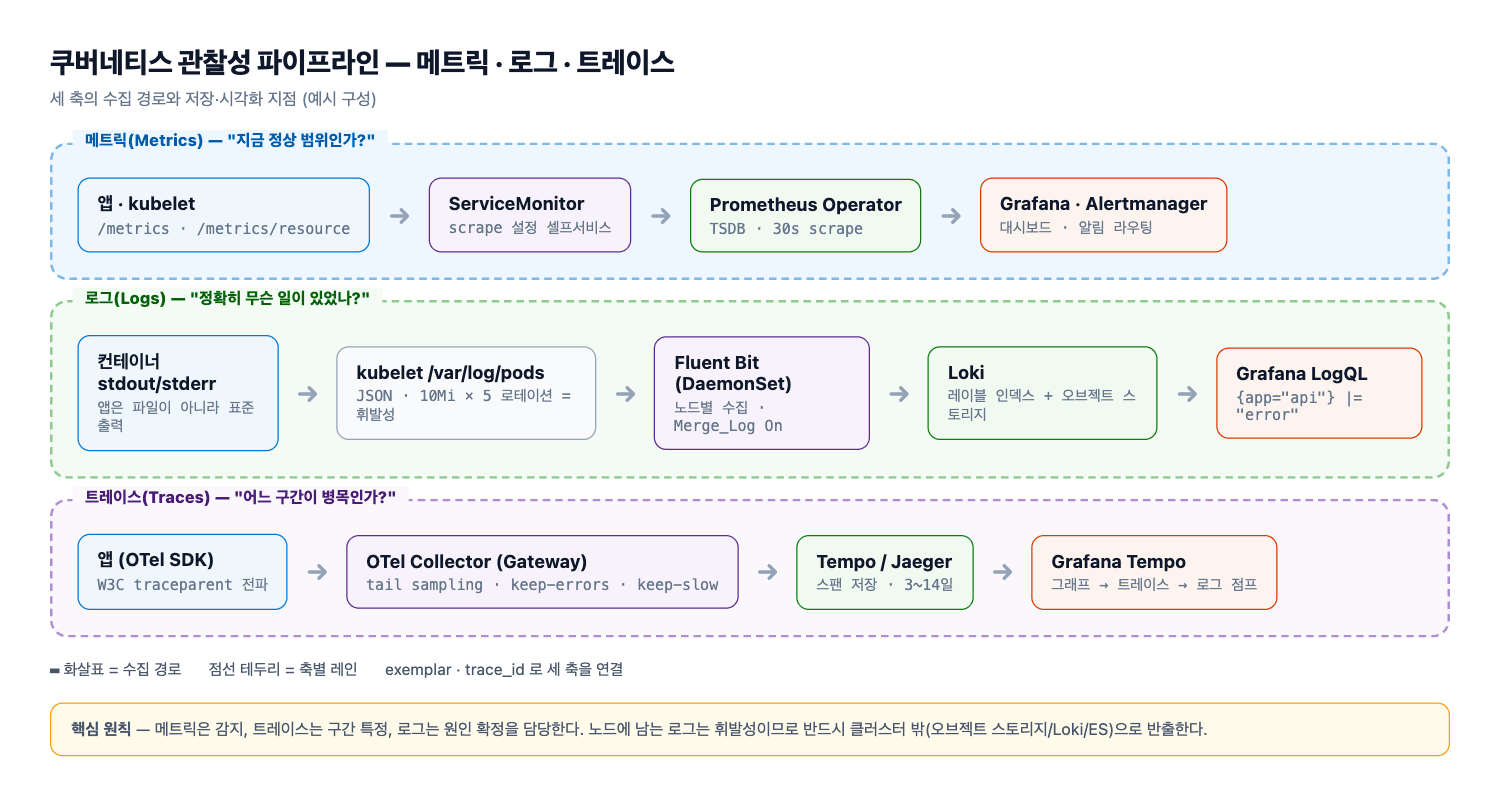
위 다이어그램은 세 축이 클러스터 안에서 출발해 저장소와 시각화 도구까지 도달하는 수집 경로를 보여준다. 메트릭은 ServiceMonitor를 통해 Prometheus가 긁어가고, 로그는 Fluent Bit 데몬셋이 노드에서 걷어 Loki로 보내며, 트레이스는 애플리케이션이 OTLP로 OTel Collector에 넘겨 Tempo에 저장된다. 세 경로가 Grafana에서 다시 만나고, trace_id와 exemplar로 서로를 가리킨다.
1.1 세 축의 역할 분담
| 축 | 답하는 질문 | 대표 도구 | 비용 특성 | 보존 기간 |
|---|---|---|---|---|
| 메트릭(Metrics) | “지금 정상 범위인가?” 추세/임계치 | Prometheus, VictoriaMetrics, CloudWatch | 시계열 수 × 카디널리티에 비례, 저렴 | 수개월(다운샘플링) |
| 로그(Logs) | “정확히 무슨 일이 있었나?” | Loki, Elasticsearch/OpenSearch, CloudWatch Logs | 볼륨 비례, 고비용 | 7~30일이 일반적 |
| 트레이스(Traces) | “어느 구간이 병목인가?” 요청 경로 | Jaeger, Tempo, X-Ray | 스팬(span) 수 비례, 샘플링 필수 | 3~14일 |
1.2 카디널리티와 레이블 관리
핵심 원칙은 카디널리티(cardinality)와 레이블 관리다. Prometheus에서 user_id, request_id, pod_name을 레이블로 넣는 순간 시계열 수가 폭발해 OOM으로 이어진다. 고유값이 높은 식별자는 레이블이 아니라 로그/트레이스/exemplar로 보낸다. 반대로 namespace, service, http_status, method, route(템플릿화된 경로)는 레이블로 적절하다.
# 나쁜 예: 고유값을 메트릭 레이블로 사용
labels:
  user_id: "u-88213"     # 시계열 폭발
  request_id: "a1b2c3d4"

# 좋은 예: 집계 가능한 차원만
track_labels:
  - namespace
  - service
  - http_status
  - method
  - route          # /api/users/{id} 형태의 템플릿 경로
2. metrics-server와 HPA 연결
kubectl top과 HPA(Horizontal Pod Autoscaler)의 CPU/메모리 기반 스케일링은 모두 metrics-server에서 나오는 metrics.k8s.io API에 의존한다. 따라서 “대시보드 그래프가 없어졌다”와 “HPA가 스케일을 못 한다”는 서로 다른 문제다.
2.1 집계만 하고 저장하지 않는다
metrics-server는 각 kubelet의 /metrics/resource를 주기적으로 긁어 집계만 하고 장기 저장은 하지 않는다(기본 15초 주기, 메모리 보관). 즉 순간값을 요청 시점에 제공하는 역할이므로, 추세를 보려면 Prometheus 같은 별도 시계열 저장소가 필요하다.
설치 후 반드시 확인할 것: kubelet 인증서 검증. 자체 서명 kubelet 인증서를 쓰는 클러스터에서는 --kubelet-insecure-tls가 없으면 모든 노드가 수집 실패한다.
# 설치 (kubelet TLS 검증을 끄는 것은 dev 클러스터 한정)
kubectl apply -f https://github.com/kubernetes-sigs/metrics-server/releases/latest/download/components.yaml

kubectl -n kube-system get deploy metrics-server
kubectl top nodes          # 여기서 에러가 나면 HPA도 반드시 실패한다
kubectl get --raw "/apis/metrics.k8s.io/v1beta1/nodes" | head -c 300
2.2 HPA 매니페스트와 requests 함정
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: api-hpa
  namespace: prod
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: api
  minReplicas: 3
  maxReplicas: 30
  metrics:
    - type: Resource
      resource:
        name: cpu
        target:
          type: Utilization
          averageUtilization: 65   # requests 기준 비율(%)
  behavior:
    scaleDown:
      stabilizationWindowSeconds: 300   # 플래핑 방지
      policies:
        - type: Percent
          value: 25
          periodSeconds: 60
함정:
averageUtilization은 컨테이너의limits가 아니라requests에 대한 비율이다.requests를 설정하지 않은 파드는 Utilization을 계산할 수 없어 HPA가unknown상태로 멈춘다. 또한 CPU 기반 스케일링은 순간 부하에 반응하지 않으므로(집계 지연 + 스케일 지연) 버스트성 트래픽은 큐 기반 커스텀 메트릭이나 KEDA를 검토한다.
3. Prometheus 생태계 — Operator, ServiceMonitor, PromQL 입문
운영 환경에서는 raw Prometheus 대신 Prometheus Operator(kube-prometheus-stack)를 쓴다. 핵심은 scrape 설정을 사람이 YAML에 직접 쓰지 않고, 서비스가 “나를 이렇게 긁어가라”라고 선언하는 셀프서비스 모델이다.
3.1 Operator와 셀프서비스 scrape
ServiceMonitor: Service + 포트를 선택해 scrape 대상 생성 (애플리케이션 팀 소유)PodMonitor: Service가 없는 파드 직접 타깃PrometheusRule: 알림/기록 규칙(recording rule) 배포Alertmanager: 그룹핑·억제·라우팅 담당
apiVersion: monitoring.coreos.com/v1
kind: ServiceMonitor
metadata:
  name: api-monitor
  namespace: prod
  labels:
    release: kube-prometheus-stack   # Prometheus의 serviceMonitorSelector와 일치해야 수집됨
spec:
  selector:
    matchLabels:
      app: api
  endpoints:
    - port: http-metrics
      path: /metrics
      interval: 30s
      scrapeTimeout: 10s
      metricRelabelings:
        - action: drop                    # 고카디널리티 지표 폐기
          sourceLabels: [__name__]
          regex: "go_gc_duration_seconds.*"
3.2 PromQL 입문 — 실전에서 자주 쓰는 다섯 형태
PromQL 입문 — 실전에서 가장 자주 쓰는 5가지 형태:
# 1) 초당 요청률 (5분 윈도우)
sum by (route) (rate(http_requests_total{job="api"}[5m]))

# 2) 5xx 에러 비율
sum(rate(http_requests_total{job="api",http_status=~"5.."}[5m]))
  / sum(rate(http_requests_total{job="api"}[5m]))

# 3) p95 레이턴시 (히스토그램)
histogram_quantile(0.95,
  sum by (le, route) (rate(http_request_duration_seconds_bucket[5m])))

# 4) requests 대비 실제 사용량 (스케일링 판단)
sum(rate(container_cpu_usage_seconds_total{namespace="prod"}[5m])) by (pod)
  / sum(kube_pod_container_resource_requests{resource="cpu"}) by (pod)

# 5) 컨테이너가 memory limit에 붙어 있는 파드
container_memory_working_set_bytes / on(pod)
  kube_pod_container_resource_limits{resource="memory"} > 0.9
rate()는 반드시 counter에만 쓴다. 게이지(gauge)에 쓰면 재시작/리셋 구간에서 음수가 나온다. 그리고 [5m] 윈도우는 scrape interval의 최소 4배를 권장한다(2배 미만이면 데이터 포인트가 1개뿐이라 값이 뭉개진다).
4. Grafana 대시보드와 알림
4.1 대시보드도 코드로 프로비저닝한다
Grafana는 4계층으로 대시보드를 구성하면 재사용이 쉽다: 골든 시그널(트래픽/에러/지연/포화) → 서비스별 → 인프라(노드/컨테이너) → 비즈니스 지표. 대시보드는 JSON으로 Git에 커밋하고 ConfigMap/사이드카로 프로비저닝해야 “누가 수동으로 고친 대시보드”가 되지 않는다.
알림은 Grafana alert rule이 아니라 PrometheusRule + Alertmanager 조합이 표준이다(평가·라우팅·억제를 코드로 관리).
apiVersion: monitoring.coreos.com/v1
kind: PrometheusRule
metadata:
  name: api-slo
  namespace: prod
spec:
  groups:
    - name: api.rules
      interval: 30s
      rules:
        - alert: ApiHighErrorRate
          expr: |
            sum(rate(http_requests_total{job="api",http_status=~"5.."}[5m]))
              / sum(rate(http_requests_total{job="api"}[5m])) > 0.05
          for: 10m                 # 순간 스파이크 무시
          labels:
            severity: page
            team: platform
          annotations:
            summary: "API 5xx 비율 5% 초과 ({{ $value | humanizePercentage }})"
            runbook_url: "https://wiki/runbooks/api-5xx"
4.2 Alertmanager 설계 원칙
Alertmanager 설계 원칙 (여기가 대부분의 “알림 피로”가 발생하는 지점이다):
for를 반드시 쓴다. 0초 알림은 배포 중 정상 트래픽 이동에도 발화한다.group_by: [alertname, namespace]+group_interval로 폭풍(storm)을 하나의 통보로 묶는다.inhibit_rules로 상위 장애가 하위 알림을 삼키게 한다(예: 노드 NotReady가 켜지면 그 노드의 파드 알림 억제).- 증상 기반(에러율/지연)으로 페이징하고, 원인 기반(CPU 90%)은 티켓/슬랙으로 보낸다. CPU 90%는 그 자체로 사용자 영향이 아니다.
route:
  receiver: slack-default
  group_by: [alertname, namespace, cluster]
  group_wait: 30s
  group_interval: 5m
  repeat_interval: 4h
  routes:
    - matchers: [severity="page"]
      receiver: pagerduty-oncall
      continue: false
receivers:
  - name: slack-default
    slack_configs:
      - channel: "#alerts"
        send_resolved: true
inhibit_rules:
  - source_matchers: [alertname="NodeNotReady"]
    target_matchers: [severity="warning"]
    equal: [node]
5. 로깅 아키텍처 — Loki vs EFK
컨테이너 로그는 기본적으로 stdout/stderr로 나가고, kubelet이 노드의 /var/log/pods/...에 JSON으로 저장한 뒤 로테이션한다(기본 10Mi × 5). 따라서 노드에 남는 로그는 휘발성이며, 클러스터 밖으로 반출하지 않으면 파드 재생성/노드 교체 시 사라진다.
5.1 Loki·EFK·관리형 비교
| 방식 | 구성 | 장점 | 단점 |
|---|---|---|---|
| Loki + Promtail/Alloy | 레이블 인덱스만 저장, 청크는 오브젝트 스토리지 | 저렴, Grafana 통합, LogQL | 전문 검색(full-text)이 약함(최근 버전에서 개선) |
| EFK/ECK | Fluent Bit → Elasticsearch → Kibana | 강력한 검색/집계 | 비용·운영 부담 큼, JVM 튜닝 필요 |
| 관리형 | CloudWatch/Fluent Bit → S3, Cloud Logging | 운영 부담 최소 | 비용 예측 어려움, 락인 |
5.2 구조화 로그와 LogQL
핵심 설계는 수집 에이전트를 데몬셋(DaemonSet)으로, 그리고 구조화 로그(JSON) 를 강제하는 것이다. message 한 줄에 모든 맥락을 넣으면 검색이 불가능해진다.
# Loki 네임스페이스의 에러 로그만, 15분 윈도우
{namespace="prod", app="api"} |= "error" | json | line_format "{{.level}} {{.path}} {{.msg}}"

# 느린 요청 추출 (숫자 비교는 LogQL에서 가능)
{app="api"} | json | duration_ms > 500 | line_format "{{.trace_id}} {{.route}} {{.duration_ms}}ms"
함정: Fluent Bit/Fluentd의 파서 설정에서
Merge_Log On과Keep_Log Off를 쓰지 않으면 JSON 본문이 문자열로 래핑되어 Loki/ES에서 필드 검색이 안 된다. 또 LogQL에서|=문자열 필터를 맨 앞에 놓지 않으면 전체 스캔으로 쿼리가 타임아웃된다.
6. OpenTelemetry와 분산 트레이싱 (Jaeger/Tempo)
트레이싱은 서비스 경계를 넘는 요청 경로를 하나의 trace_id로 묶는다. 도입 순서는 전파(propagation) → 계측 → 수집 → 샘플링이며, 전파가 깨지면 뒤가 전부 무의미하다.
6.1 전파 → 계측 → 수집 → 샘플링
- 전파: W3C
traceparent헤더가 표준. HTTP 클라이언트/서버, 메시지 큐 헤더에 컨텍스트를 주입/추출해야 한다. HTTP만 계측하고 DB 호출/Kafka 발행을 계측하지 않으면 트레이스가 끊긴다. - 수집: OpenTelemetry Collector를 Deployment(게이트웨이) 또는 DaemonSet(에이전트)으로 배포. 애플리케이션은 OTLP로 Collector에만 보내면 백엔드(Jaeger/Tempo/X-Ray) 교체가 자유롭다.
- 샘플링: head sampling(Collector/에이전트,
probabilistic)은 저렴하지만 드문 에러를 놓친다. tail sampling(Collector, 전체 스팬을 모아 결정)은error또는latency > 임계치트레이스를 100% 보존할 수 있으나 메모리를 크게 쓴다. - 연결: 메트릭 exemplar와 로그의
trace_id를 맞춰두면 Grafana에서 “그래프 스파이크 → 해당 트레이스 → 해당 요청 로그”로 한 번에 점프할 수 있다.
6.2 Collector 게이트웨이 구성
# OpenTelemetry Collector (게이트웨이, tail sampling)
apiVersion: opentelemetry.io/v1beta1
kind: OpenTelemetryCollector
metadata:
  name: otel-gateway
spec:
  mode: deployment
  config:
    receivers:
      otlp:
        protocols:
          grpc: {endpoint: 0.0.0.0:4317}
          http: {endpoint: 0.0.0.0:4318}
    processors:
      memory_limiter: {check_interval: 1s, limit_percentage: 75}
      batch: {timeout: 5s, send_batch_size: 1024}
      tail_sampling:
        decision_wait: 10s
        policies:
          - name: keep-errors
            type: status_code
            status_code: {status_codes: [ERROR]}
          - name: keep-slow
            type: latency
            latency: {threshold_ms: 500}
          - name: sample-rest
            type: probabilistic
            probabilistic: {sampling_percentage: 5}
    exporters:
      otlp/tempo:
        endpoint: tempo-distributor.observability:4317
        tls: {insecure: true}
    service:
      pipelines:
        traces:
          receivers: [otlp]
          processors: [memory_limiter, tail_sampling, batch]
          exporters: [otlp/tempo]
7. kubectl 디버깅 워크플로
순서를 고정해 두면 추측을 줄일 수 있다: get → describe → logs → exec → events. describe를 건너뛰고 로그부터 보는 습관이 가장 흔한 시간 낭비다. 스케줄링 실패·이미지 풀 실패는 애플리케이션 로그에 아무것도 남기지 않는다.
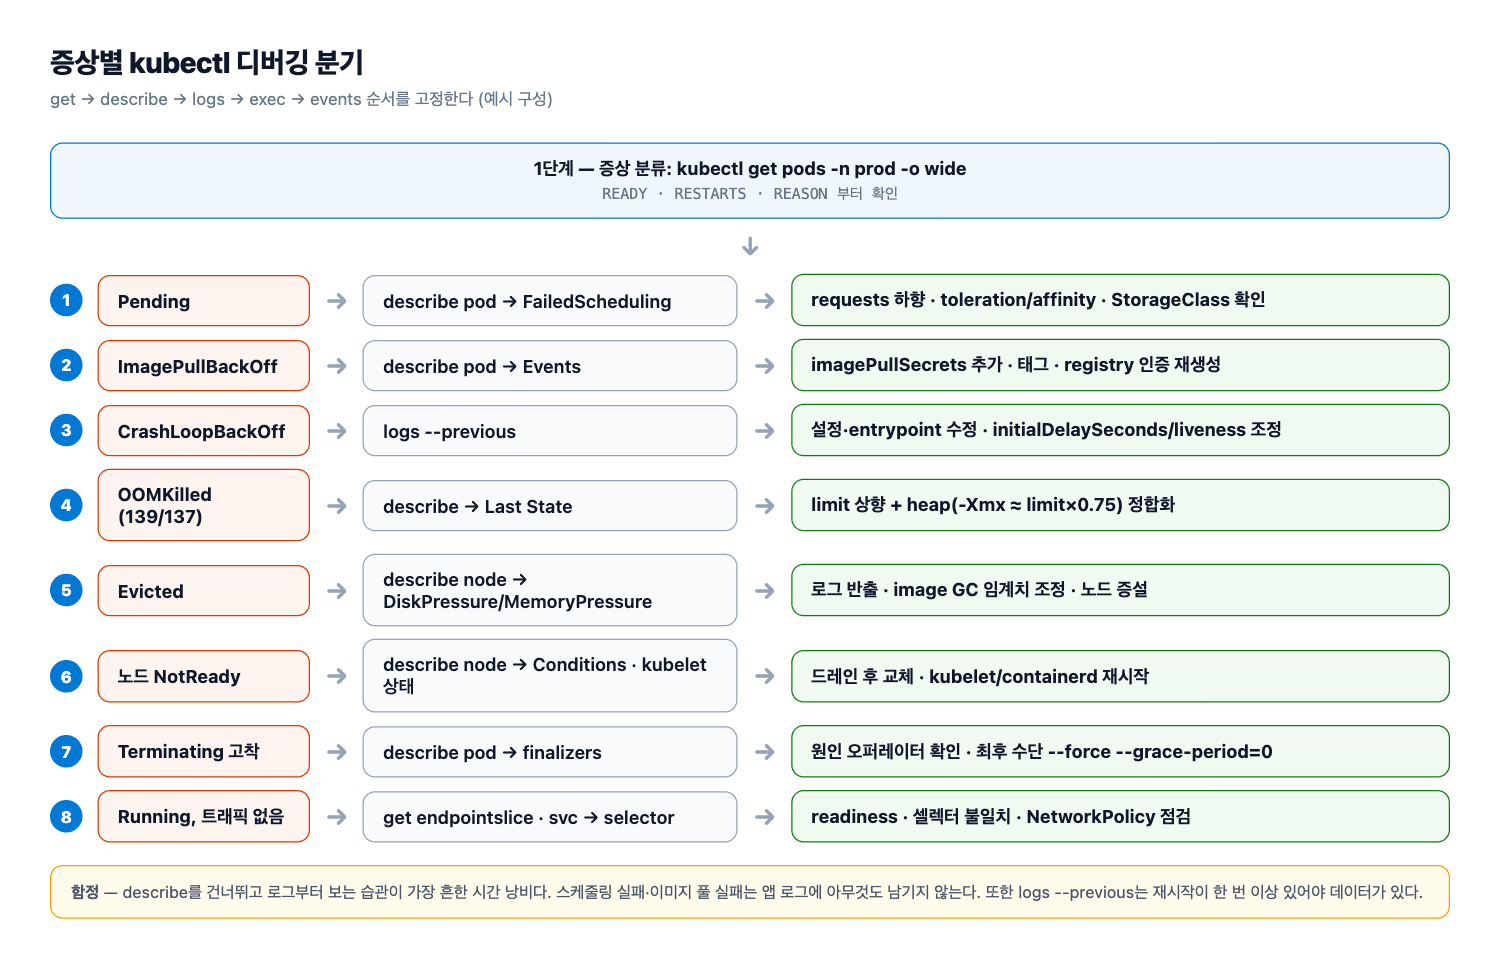
위 그림은 증상을 먼저 분류한 뒤 어느 명령으로 들어갈지 정하는 분기를 나타낸다. Pending과 ImagePullBackOff는 애플리케이션 로그가 아니라 describe의 Events와 스케줄러 사유로, CrashLoopBackOff는 logs --previous로, OOMKilled는 컨테이너의 Last State로 각각 경로가 갈린다.
7.1 다섯 단계 명령
# 1) 상태와 재시작 횟수 파악
kubectl get pods -n prod -o wide
kubectl get pods -n prod -o custom-columns=\
NAME:.metadata.name,READY:.status.containerStatuses[0].ready,\
RESTARTS:.status.containerStatuses[0].restartCount,\
REASON:.status.containerStatuses[0].state.waiting.reason

# 2) 이벤트/조건/볼륨/스케줄 사유 한 번에
kubectl describe pod api-7d9f -n prod            # Events 섹션이 핵심
kubectl describe node ip-10-0-3-14

# 3) 이전 컨테이너(죽은 프로세스) 로그 — CrashLoop의 진짜 원인은 여기에 있다
kubectl logs api-7d9f -n prod -c api --previous --tail=200
kubectl logs -n prod -l app=api --since=10m --prefix

# 4) 살아 있는 파드 내부 확인 (임시 컨테이너는 distroless에서 유일한 수단)
kubectl exec -it api-7d9f -n prod -c api -- sh
kubectl debug -it api-7d9f -n prod --image=nicolaka/netshoot --target=api

# 5) 클러스터 이벤트 (최신순, 노드 레벨 문제 포함)
kubectl get events -A --sort-by=.lastTimestamp | tail -40
kubectl get events -n prod --field-selector reason=FailedScheduling
7.2 –previous와 셀렉터 함정
함정:
kubectl logs --previous는 재시작이 한 번 이상 있어야 데이터가 있다. 또 Deployment 로그를kubectl logs deploy/api로 볼 때는 파드 1개만 붙으므로, 여러 레플리카를 보려면-l셀렉터 +--prefix를 쓴다.
8. 대표 장애 진단표
8.1 증상별 원인→해결 매핑
| 증상 | 1차 확인 | 흔한 원인 | 해결 |
|---|---|---|---|
| CrashLoopBackOff | logs --previous |
앱 시작 실패(설정/DB 미도달), OOM, 잘못된 entrypoint | 설정 수정, initialDelaySeconds/liveness 조정 |
| ImagePullBackOff / ErrImagePull | describe pod Events |
이미지 태그 오타(latest 미존재), private registry 인증 실패 |
imagePullSecrets 추가, imagePullSecret의 dockerconfig 재생성 |
| Pending (무한) | describe pod → FailedScheduling |
requests 과다로 노드에 자리 없음, taint/toleration 불일치, PVC 바인딩 대기 | requests 하향, toleration/affinity 추가, StorageClass 확인 |
| OOMKilled (139/137) | describe Last State |
memory limit 초과(누수 또는 limit 과소) | limit 상향 + heap 설정(-Xmx ≈ limit×0.75) 정합화 |
| Evicted | describe node DiskPressure/MemoryPressure |
노드 디스크 압박(로그/이미지), 메모리 부족 | 로그 반출, image GC 임계치 조정, 노드 증설 |
| 노드 NotReady | describe node Conditions, kubelet 상태 |
kubelet 행(hang), 런타임(containerd) 다운, CNI/디스크 압박, 네트워크 단절 | 노드 드레인 후 교체, kubelet/containerd 재시작 |
| Terminating에서 안 사라짐 | describe pod finalizers |
finalizer 미처리, kubelet 미응답 | 원인 오퍼레이터 확인, 최후 수단 --force --grace-period=0 |
| 파드는 Running인데 트래픽 없음 | get endpoints/EndpointSlice |
readiness 실패, 셀렉터 불일치, NetworkPolicy | probe·labels·policy 점검 |
8.2 Exit code 빠른 참조
Exit code 빠른 참조: 137 = SIGKILL(대개 OOM 또는 liveness kill), 143 = SIGTERM(정상 종료 요청), 1 = 애플리케이션 예외, 126/127 = 실행 권한/바이너리 없음.
9. 리소스 진단 — top과 CPU throttling
kubectl top은 순간값만 보여주므로 추세 판단에는 부적합하다. 중요한 것은 throttling이다. 컨테이너는 CPU limit을 초과하면 죽지 않고 CFS quota로 강제로 멈춘다. 즉 p99 지연이 튀는데 CPU 사용량은 낮게 보이는 전형적 패턴이 나온다.
9.1 실제 사용량·할당률·throttle 확인
# 파드/컨테이너 실제 사용량
kubectl top pod -n prod --containers --sort-by=cpu | head -20

# 노드 할당률 (requests/limits 합계 vs capacity)
kubectl describe node | grep -A6 "Allocated resources"

# throttle 여부 확인 (cAdvisor 지표)
kubectl get --raw "/api/v1/nodes/$NODE/proxy/metrics/cadvisor" \
  | grep -E 'container_cpu_cfs_(throttled_periods|periods)_total' | head
9.2 throttling 비율 PromQL
# 컨테이너 CPU throttling 비율 — 0.2(20%) 이상이면 limit 상향 검토
sum by (namespace, pod, container)
  (rate(container_cpu_cfs_throttled_periods_total[5m]))
  / sum by (namespace, pod, container)
  (rate(container_cpu_cfs_periods_total[5m]))
10. 네트워크 디버깅
“연결이 안 된다”는 DNS → Service/Endpoint → NetworkPolicy → 라우팅/CNI 순으로 좁힌다. 대부분은 앞의 두 단계에서 끝난다.
10.1 netshoot으로 파드처럼 진입하기
# netshoot 파드로 파드처럼 진입 (DNS/HTTP/포트 테스트 도구 포함)
kubectl run netdebug -n prod --rm -it --image=nicolaka/netshoot --restart=Never -- bash

# 컨테이너 내부에서:
nslookup api.prod.svc.cluster.local
curl -sv --max-time 3 http://api.prod.svc.cluster.local:8080/healthz
nc -zv 10.0.5.21 5432
conntrack -L | grep 5432        # NAT/연결 상태

# Service에 엔드포인트가 있는가 (가장 흔한 원인: readiness 실패)
kubectl get endpointslice -n prod -o wide
kubectl get svc api -n prod -o jsonpath='{.spec.selector}'
10.2 자주 나오는 에러 매핑
자주 나오는 에러 매핑:
no such host→ Service 이름/네임스페이스 오타 또는 CoreDNS 장애(kubectl -n kube-system logs deploy/coredns)connection refused→ 엔드포인트는 있으나 포트/프로세스가 안 뜸(targetPort 오타,containerPort불일치)context deadline exceeded(timeout) → NetworkPolicy 차단 또는 라우팅/CNI 문제. 같은 네임스페이스인데 안 되면 NetworkPolicy부터 의심한다- 간헐적 5xx → 노드 간 MTU 불일치(오버레이 캡슐화로 1500을 초과) 의심,
ping -M do -s 1400으로 확인
11. 실무 체크리스트
- 모든 워크로드에
requests가 설정되어 있고, HPA 대상은 CPU/메모리 requests가 반드시 존재한다 kubectl top nodes/pods가 정상 동작하며 metrics-server가 Ready 상태다- Prometheus가 모든 네임스페이스의 ServiceMonitor를 수집하는지(
serviceMonitorSelector라벨) 확인했고, 고카디널리티 지표를 drop 규칙으로 차단했다 - 모든 알림 규칙에
for와runbook_url이 있고, 증상 기반 알림과 원인 기반 알림이 분리되어 있다 - Alertmanager에
inhibit_rules와group_by가 구성되어 알림 폭풍 시나리오를 검증했다 - 애플리케이션 로그가 구조화 JSON이고
trace_id를 포함하며, 노드 밖(오브젝트 스토리지/Loki/ES)으로 반출된다 - 분산 트레이싱에서 W3C 전파가 서비스 경계를 넘어 유지되고, tail sampling으로 에러/지연 트레이스가 보존된다
- CrashLoopBackOff·Pending·OOMKilled 발생 시
describe→logs --previous순서로 확인하는 런북이 문서화되어 있다 - CPU throttling 비율과 메모리 limit 근접도(working_set/limit > 0.9)를 대시보드에서 상시 감시한다
- 노드 NotReady/드레인, etcd 지연, CoreDNS·CNI 장애에 대한 클러스터 레벨 알림과 대응 절차가 있다
12. 정리
- 축을 나눠 설계한다. 메트릭은 감지, 트레이스는 구간 특정, 로그는 원인 확정이다. 세 축은 대체재가 아니므로 수집 경로를 미리 그려 둔다.
- 카디널리티가 비용이다. 고유값(
user_id,request_id)은 레이블이 아니라 로그·트레이스·exemplar로 보낸다. - 알림은 증상 기반으로.
for·group_by·inhibit_rules를 갖추고, CPU 90% 같은 원인 지표는 페이징 대신 티켓으로 보낸다. - 로그는 노드 밖으로. 노드에 남는 로그는 휘발성이므로 Fluent Bit 데몬셋으로 걷어 구조화 JSON으로 반출한다.
- 순서를 고정한다. get → describe → logs → exec → events.
describe를 건너뛰면 스케줄링·이미지 실패를 놓친다.
References
- Kubernetes Documentation — Metrics for Kubernetes System Components (metrics-server)
- Kubernetes Documentation — Debugging Pods
- Kubernetes Documentation — Debugging Kubernetes Nodes
- Prometheus — Querying basics (PromQL)
- OpenTelemetry — Collector
- Grafana Loki — LogQL
댓글남기기