
쿠버네티스 워크로드: Pod·Deployment·StatefulSet·Job과 오토스케일링
이 시리즈는 쿠버네티스와 클라우드(AWS·GCP·Azure 공통 개념)를 실무 관점에서 정리한 기록이다. 핵심 개념·코드 예제·실전 함정(gotcha) 중심으로, 학습과 설계 리뷰·장애 대응에 바로 쓸 수 있게 구성했다. 각 편은 독립적으로 읽을 수 있고, 순서대로 보면 클러스터 내부 구조에서 클라우드 운영까지 하나의 흐름으로 이어진다.
이번 편은 그중 워크로드(workload) 계층을 다룬다. 앞선 쿠버네티스 기초에서 컨트롤 플레인과 조정 루프(observe → diff → act)를 봤다면, 이번에는 그 조정 루프가 실제로 관리하는 대상—”컨테이너를 어떤 단위로, 몇 개나, 어떤 순서와 규칙으로 실행할 것인가”를 선언하는 API 객체—을 파고든다. 파드(Pod)라는 최소 실행 단위 위에 어떤 컨트롤러가 어떤 보장을 얹는지, 그리고 다음 편의 쿠버네티스 네트워킹으로 넘어가기 전에 부하에 따라 개수를 조정하는 오토스케일링까지 한 번에 정리한다.
- 다섯 워크로드 컨트롤러가 각각 무엇을 보장하는지, 언제 무엇을 고를지 판단 기준을 세운다
- 워크로드 매니페스트의 실전 패턴(requests/limits·프로브·멀티컨테이너)을 그대로 쓸 수 있게 본다
- Pod 오토스케일러와 노드 오토스케일러의 순서와 의존 관계를 정리한다
- 스케줄링 제어(친화성·테인트·PDB·토폴로지 분산)의 하드/소프트 선택을 구분한다
- 운영에서 반복되는 증상→원인→해결과 실무 체크리스트를 남긴다
1. Pod: 최소 배포 단위
쿠버네티스(Kubernetes)에서 워크로드(workload)는 “컨테이너를 어떤 단위로, 몇 개나, 어떤 순서와 규칙으로 실행할 것인가”를 선언하는 API 객체다. 파드(Pod)라는 최소 실행 단위 위에 ReplicaSet, Deployment, StatefulSet, DaemonSet, Job/CronJob이 각각 다른 보장(무상태 복제, 순서·영속성, 노드당 1개, 완료 보장)을 얹고, 그 위에 HPA·VPA·KEDA와 Cluster Autoscaler/Karpenter가 부하에 따라 개수를 조정한다.
파드는 하나 이상의 컨테이너를 같은 네트워크 네임스페이스(Network namespace)·IPC·볼륨(Volume)을 공유하며 묶은 단위다. 즉 같은 파드의 컨테이너는 localhost로 통신하고, IP와 라이프사이클을 함께한다. 파드는 “일회용(ephemeral)”이며 직접 만들기보다 상위 컨트롤러(controller)가 관리하도록 선언하는 것이 원칙이다.
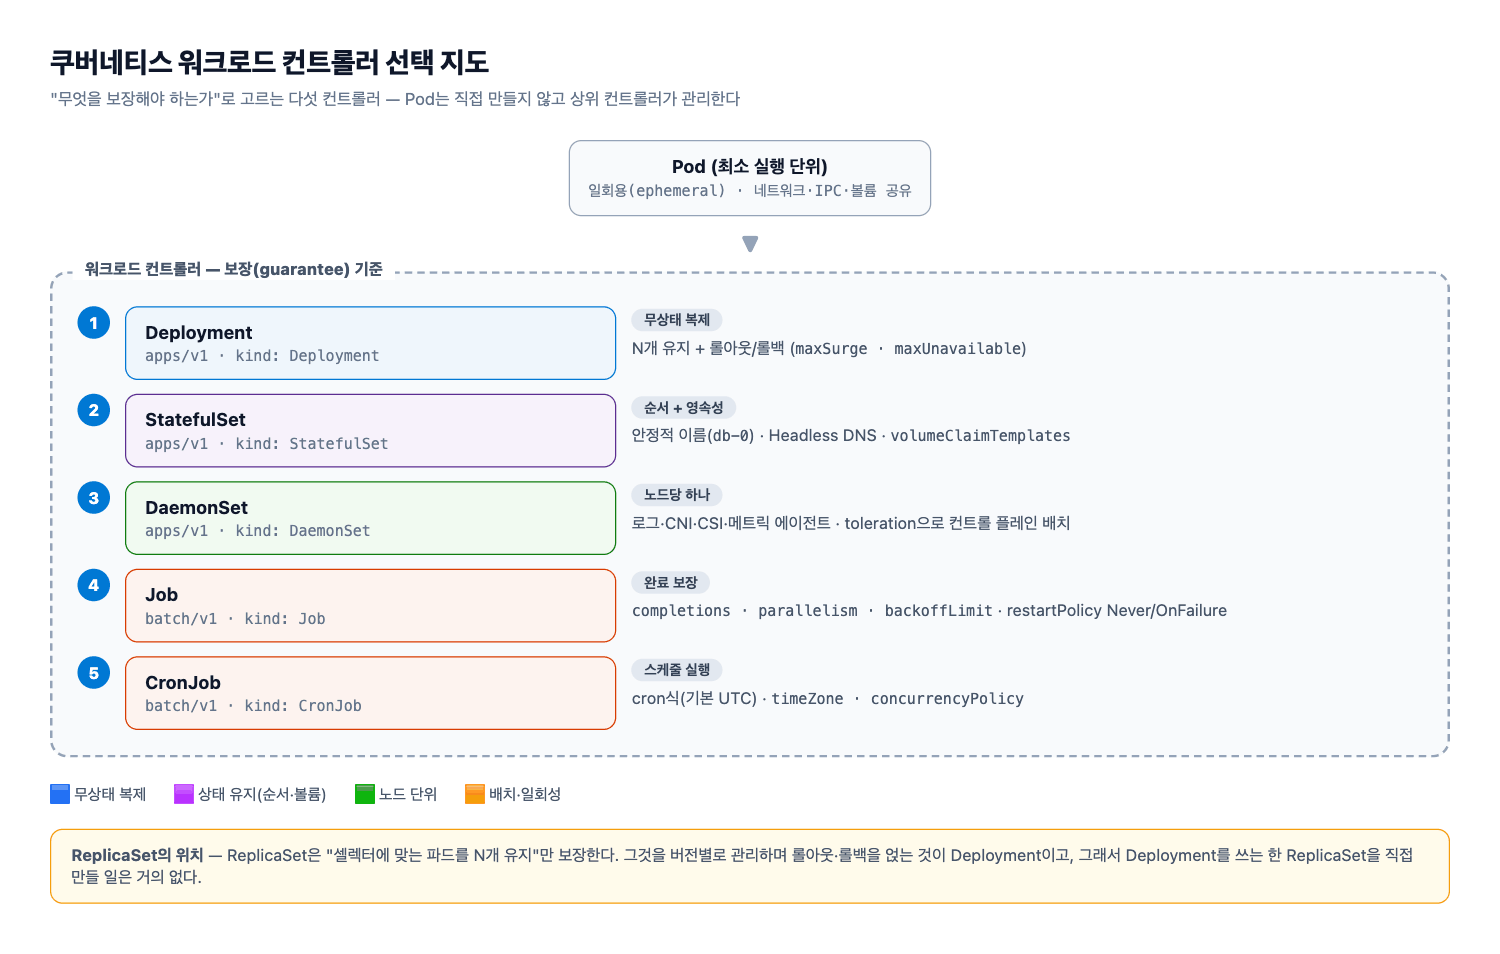
위 다이어그램은 파드 위에 얹히는 다섯 컨트롤러(Deployment·StatefulSet·DaemonSet·Job·CronJob)를 “무엇을 보장하는가”라는 기준으로 고르는 지도를 나타낸다. 무상태 복제는 Deployment, 순서와 영속성은 StatefulSet, 노드당 하나는 DaemonSet, 완료 보장은 Job/CronJob이 맡는다.
1.1 생명주기(phases)와 컨테이너 상태
- Phase:
Pending→Running→Succeeded/Failed, 노드 통신 소실 시Unknown. Phase는 파드 전체 수준이고, 컨테이너별 상태는waiting/running/terminated로 별도 표기된다. - 재시작 정책:
restartPolicy는Always(기본, 워크로드),OnFailure,Never(Job) 중 하나이며 파드 단위에서만 유효하다. - 종료 흐름: 삭제 요청 → preStop 훅 → SIGTERM →
terminationGracePeriodSeconds(기본 30초) 대기 → SIGKILL.
1.2 프로브(Probe): liveness / readiness / startup
세 프로브는 목적이 완전히 다르며, 하나로 뭉뚱그리면 장애를 증폭시킨다.
| 프로브 | 실패 시 동작 | 용도 |
|---|---|---|
| liveness | 컨테이너 재시작 | 교착(deadlock)에서 복구 |
| readiness | 엔드포인트(Endpoint)에서 제외 | 트래픽 수용 가능 여부 |
| startup | 준비될 때까지 liveness/readiness 유예 | 기동이 느린 앱 보호 |
apiVersion: v1
kind: Pod
metadata:
  name: web
spec:
  terminationGracePeriodSeconds: 30
  containers:
    - name: web
      image: nginx:1.27
      ports:
        - containerPort: 80
      startupProbe:                 # 최대 30 x 2s = 60s 유예
        httpGet: { path: /healthz, port: 80 }
        periodSeconds: 2
        failureThreshold: 30
      readinessProbe:
        httpGet: { path: /ready, port: 80 }
        periodSeconds: 5
        failureThreshold: 2
      livenessProbe:
        httpGet: { path: /healthz, port: 80 }
        periodSeconds: 10
        failureThreshold: 3
2. requests/limits와 QoS 클래스
requests는 스케줄러(scheduler)가 노드 용량을 계산할 때 쓰는 예약량이고, limits는 커널 cgroup이 강제하는 상한이다. CPU의 limit 초과는 스로틀링(throttling)(속도 저하), 메모리 limit 초과는 OOMKill(exit 137)이라는 결과 차이를 반드시 기억해야 한다.
| QoS 클래스 | 조건 | 노드 압박 시 축출 순위 |
|---|---|---|
| Guaranteed | 모든 컨테이너에 CPU·메모리 requests = limits | 가장 낮음(마지막) |
| Burstable | requests < limits 또는 requests만 설정 | 중간 |
| BestEffort | requests·limits 모두 미설정 | 가장 높음(먼저) |
2.1 함정
- CPU는 압축 가능(compressible) 자원이라 limit을 걸면 스로틀만 발생하고 죽지 않는다. 지연 민감 서비스는
requests = limits로 두고 Guaranteed를 노리는 편이 예측 가능하다. - 메모리는 압축 불가라 초과분이 곧 죽음이다. JVM은
-XX:MaxRAMPercentage=75처럼 컨테이너 인식 플래그를 쓰지 않으면 힙이 limit을 넘겨 OOMKill 된다. - requests 없는 워크로드는 HPA가
<unknown>이 되고 스케줄러가 노드를 과밀 배치한다.
3. 멀티컨테이너 패턴: init과 sidecar
- init 컨테이너: 메인 컨테이너보다 먼저 순차 실행되고 반드시 완료되어야 한다. 마이그레이션, 의존 서비스 대기, 설정 생성에 쓴다. 실패하면 파드는 재시작 정책에 따라 재시도한다.
- sidecar(사이드카): 메인과 수명을 함께하는 보조 컨테이너(로그 수집, 프록시, 메트릭 노출). 쿠버네티스 1.29+의 네이티브 사이드카(native sidecar)는
initContainers에restartPolicy: Always를 주어 기동 순서와 종료 순서를 보장한다. - 그 외 앰배서더(ambassador, 외부 프록시 위임), 어댑터(adapter, 출력 정규화) 패턴이 있다.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: api
spec:
  replicas: 3
  selector:
    matchLabels: { app: api }
  template:
    metadata:
      labels: { app: api }
    spec:
      initContainers:
        - name: wait-db                       # 순차 실행, 완료 필요
          image: busybox:1.36
          command: ["sh", "-c", "until nc -z db 5432; do sleep 2; done"]
        - name: log-shipper                   # 네이티브 사이드카
          image: fluent/fluent-bit:3.1
          restartPolicy: Always
          volumeMounts: [{ name: logs, mountPath: /var/log/app }]
      containers:
        - name: api
          image: ghcr.io/acme/api:1.4.2
          volumeMounts: [{ name: logs, mountPath: /var/log/app }]
      volumes:
        - name: logs
          emptyDir: {}
4. ReplicaSet과 Deployment
ReplicaSet(RS)은 “라벨 셀렉터(label selector)에 맞는 파드를 N개 유지”만 보장한다. Deployment는 RS를 버전별로 관리하며 롤아웃(rollout)과 롤백(rollback)을 제공하는 상위 추상화다. Deployment를 쓰는 한 RS를 직접 만들 일은 거의 없다.
- RollingUpdate(기본):
maxSurge(초과 허용)와maxUnavailable(동시 중단 허용)로 속도와 가용성을 조율. 무중단이 필요하면maxUnavailable: 0. - Recreate: 기존 파드를 전부 종료 후 새로 생성. 단일 인스턴스 DB 스키마 변경 등 동시 실행이 불가능할 때만 사용.
revisionHistoryLimit,minReadySeconds,progressDeadlineSeconds로 롤아웃 실패 판정을 제어한다.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: api
spec:
  replicas: 6
  revisionHistoryLimit: 5
  minReadySeconds: 10
  progressDeadlineSeconds: 600
  strategy:
    type: RollingUpdate
    rollingUpdate: { maxSurge: 1, maxUnavailable: 0 }
  selector:
    matchLabels: { app: api }
  template:
    metadata:
      labels: { app: api }
    spec:
      containers:
        - name: api
          image: ghcr.io/acme/api:1.4.2
          resources:
            requests: { cpu: 500m, memory: 512Mi }
            limits:   { cpu: "1",  memory: 1Gi }
kubectl rollout status deploy/api --timeout=180s
kubectl rollout history deploy/api --revision=3
kubectl set image deploy/api api=ghcr.io/acme/api:1.5.0
kubectl rollout undo deploy/api --to-revision=2
kubectl rollout restart deploy/api          # 템플릿 해시를 바꿔 재생성
kubectl rollout pause deploy/api            # 카나리 구간 정지
5. StatefulSet: 순서와 영속성
StatefulSet은 ① 안정적인 파드 이름(db-0, db-1…), ② 안정적 네트워크 ID(Headless Service의 DNS), ③ 파드별 영속 볼륨을 보장한다. 기본 podManagementPolicy: OrderedReady는 0번이 Ready여야 1번을 만들고, 종료는 역순(N-1 → 0)이다. 스케일 아웃은 순차적이고 느리므로 병렬이 필요하면 Parallel로 바꾼다.
핵심은 Headless Service(clusterIP: None)다. 개별 파드가 db-0.db-headless.ns.svc.cluster.local로 직접 주소 지정되며, 이것이 DB 클러스터의 피어 디스커버리 기반이 된다. volumeClaimTemplates는 파드마다 PVC를 자동 생성하며, StatefulSet을 삭제해도 PVC는 남는다(데이터 보호를 위한 의도된 동작).
apiVersion: v1
kind: Service
metadata: { name: db-headless }
spec:
  clusterIP: None
  selector: { app: db }
  ports: [{ name: pg, port: 5432 }]
---
apiVersion: apps/v1
kind: StatefulSet
metadata: { name: db }
spec:
  serviceName: db-headless
  replicas: 3
  podManagementPolicy: OrderedReady
  selector: { matchLabels: { app: db } }
  template:
    metadata: { labels: { app: db } }
    spec:
      terminationGracePeriodSeconds: 60
      containers:
        - name: postgres
          image: postgres:16
          volumeMounts: [{ name: data, mountPath: /var/lib/postgresql/data }]
  volumeClaimTemplates:
    - metadata: { name: data }
      spec:
        accessModes: ["ReadWriteOnce"]
        storageClassName: gp3
        resources: { requests: { storage: 100Gi } }
6. DaemonSet: 노드당 하나
DaemonSet은 (테인트를 감수하는) 모든 노드에 파드를 정확히 하나씩 배치한다. 노드 추가 시 자동 확장되고 노드 제거 시 함께 정리된다. 로그 수집기, CNI, CSI, 노드 메트릭 에이전트가 대표 사례다. resources를 지정하지 않으면 노드 자원을 잠식하므로 반드시 limits를 건다. 컨트롤 플레인 노드에도 배치하려면 해당 테인트에 대한 toleration을 명시한다.
7. Job과 CronJob: 완료 보장
Job은 “N개 성공까지”를 보장하는 배치(batch) 워크로드다. completions/parallelism으로 병렬성을, backoffLimit으로 재시도를, activeDeadlineSeconds로 최대 실행 시간을, ttlSecondsAfterFinished로 잡 객체 자동 정리를 제어한다. restartPolicy는 Never 또는 OnFailure만 허용된다.
CronJob은 Job을 스케줄링한다. 스케줄은 기본 UTC이므로 timeZone(1.27+)을 명시하거나 cron식을 UTC로 작성해야 한다. concurrencyPolicy(Allow/Forbid/Replace)와 startingDeadlineSeconds를 설정하지 않으면 잡이 겹치거나 조용히 누락된다.
apiVersion: batch/v1
kind: CronJob
metadata: { name: nightly-report }
spec:
  schedule: "0 3 * * *"
  timeZone: "Asia/Seoul"
  concurrencyPolicy: Forbid
  startingDeadlineSeconds: 300
  successfulJobsHistoryLimit: 3
  failedJobsHistoryLimit: 1
  jobTemplate:
    spec:
      backoffLimit: 4
      activeDeadlineSeconds: 1800
      ttlSecondsAfterFinished: 86400
      template:
        spec:
          restartPolicy: Never
          containers:
            - name: report
              image: ghcr.io/acme/report:2.1.0
8. 오토스케일링
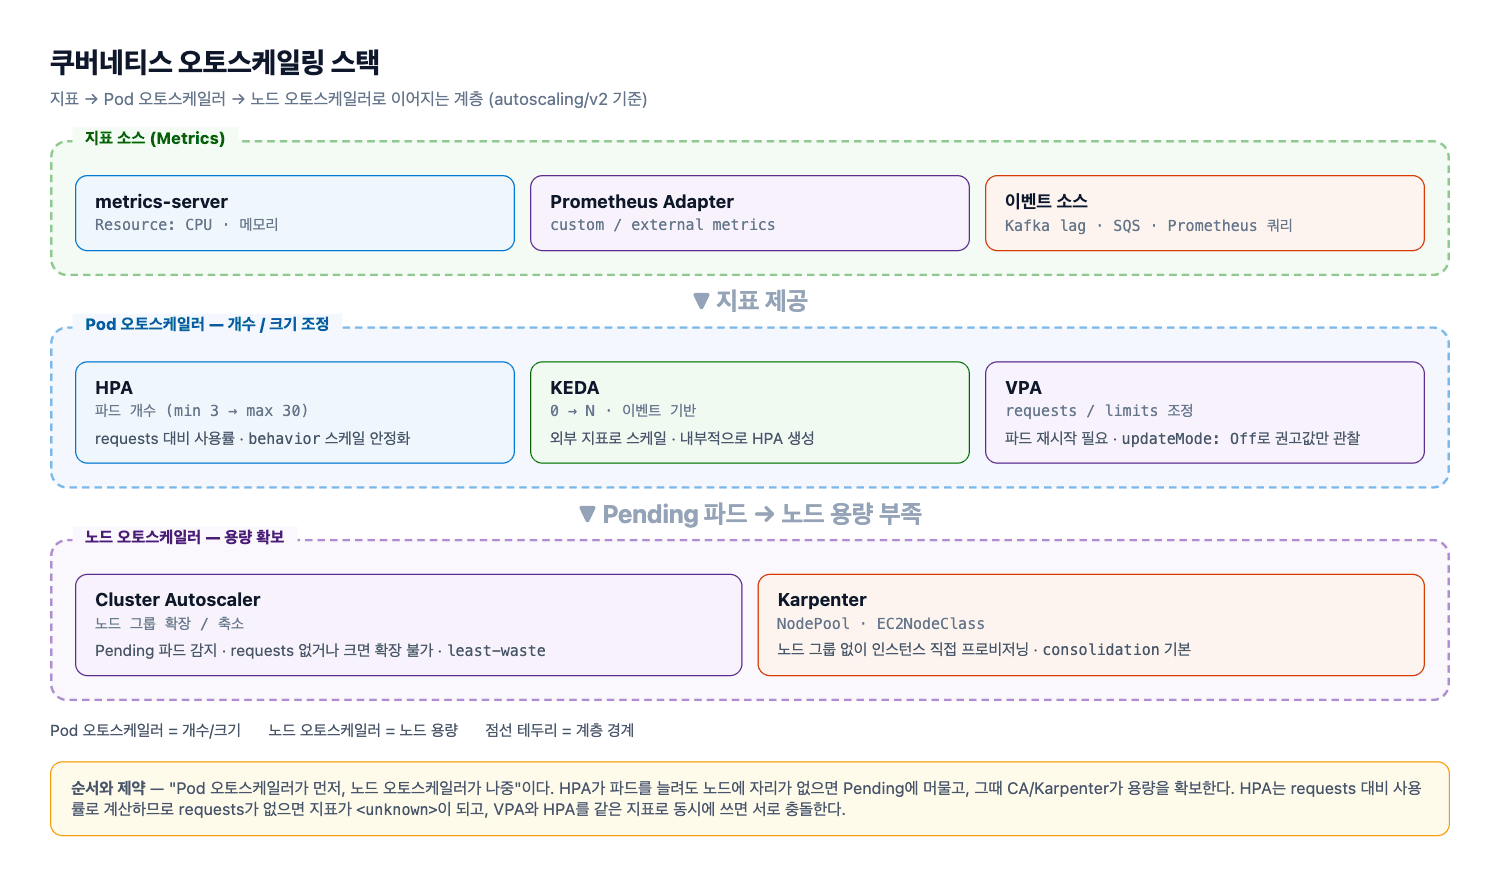
위 다이어그램은 지표 소스(metrics-server·Prometheus·이벤트 스케일러) 위에 Pod 오토스케일러(HPA·VPA·KEDA)가, 그 아래 노드 오토스케일러(Cluster Autoscaler·Karpenter)가 놓이는 계층 구조를 나타낸다. HPA가 파드 개수를 늘려도 노드에 자리가 없으면 파드가 Pending에 머물고, 그때 노드 오토스케일러가 용량을 확보한다.
8.1 HPA (Horizontal Pod Autoscaler)
파드 개수를 수평 조정한다. CPU/메모리 기반이면 대상 파드에 requests가 반드시 있어야 하며, 없으면 지표가 <unknown>으로 뜬다. autoscaling/v2에서는 커스텀/외부 지표와 behavior(스케일 안정화 창, 정책)를 지원한다. 스케일 다운은 진동을 막기 위해 기본적으로 관성이 크다.
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata: { name: api }
spec:
  scaleTargetRef: { apiVersion: apps/v1, kind: Deployment, name: api }
  minReplicas: 3
  maxReplicas: 30
  metrics:
    - type: Resource
      resource:
        name: cpu
        target: { type: Utilization, averageUtilization: 70 }
    - type: Pods
      pods:
        metric: { name: http_requests_per_second }
        target: { type: AverageValue, averageValue: "200" }
  behavior:
    scaleDown:
      stabilizationWindowSeconds: 300
      policies: [{ type: Percent, value: 50, periodSeconds: 60 }]
    scaleUp:
      stabilizationWindowSeconds: 0
      policies: [{ type: Percent, value: 100, periodSeconds: 30 }]
8.2 VPA / KEDA / Cluster Autoscaler / Karpenter
- VPA(Vertical Pod Autoscaler): requests/limits를 조정한다. 파드 재시작이 필요하므로 HPA와 같은 지표(CPU/메모리)로 동시 사용하면 서로 충돌한다(
updateMode: Off로 권고값만 관찰하는 방식이 안전). - KEDA: 이벤트 기반 오토스케일러. Kafka lag, SQS 대기열 길이, Prometheus 쿼리 등 외부 지표로 0 → N까지 스케일한다. 내부적으로 HPA를 생성한다.
- Cluster Autoscaler(CA): Pending 파드가 생기면 노드 그룹을 확장한다. 즉 “Pod 오토스케일러가 먼저, 노드 오토스케일러가 나중“이며, 파드에 requests가 없거나 커서 어떤 노드에도 안 맞으면 CA는 절대 확장하지 않는다. AWS에서는 AZ 균형을 위해
balance-similar-node-groups와--expander=least-waste튜닝이 필요하다. - Karpenter: 노드 그룹 없이 워크로드 요구(리소스, 아키텍처, 스팟 허용, 토폴로지)에 맞는 인스턴스를 직접 프로비저닝한다.
NodePool/EC2NodeClass로 정의하며, consolidation(유휴 노드 통합)이 기본 동작이라 PDB와 함께 검증해야 한다.
9. 스케줄링 제어: 친화성·테인트·PDB·토폴로지 분산
- nodeAffinity / nodeSelector: 특정 노드 레이블로 배치를 제한한다(
required는 하드,preferred는 소프트). - podAntiAffinity: 같은 앱 파드를 서로 다른 노드/AZ에 흩어 가용성을 높인다. 대규모에서는 스케줄러 부하가 급증하므로
topologySpreadConstraints가 더 낫다. - topologySpreadConstraints:
maxSkew로 존/노드 간 편차를 직접 제어한다.whenUnsatisfiable: DoNotSchedule은 하드,ScheduleAnyway는 소프트다. - 테인트(Taint) / 톨러레이션(Toleration): 노드가 파드를 “밀어내는” 규칙이다. 테인트는 노드에, 톨러레이션은 파드에 붙는다. GPU 노드 분리, 전용 테넌트 격리에 쓴다.
- PDB(PodDisruptionBudget): 자발적 중단(노드 드레인, CA 축소) 시 최소 가용 수를 보장한다.
minAvailable: 1+ replicas: 1 조합은 드레인을 영구히 막는 함정이다.
apiVersion: apps/v1
kind: Deployment
metadata: { name: api }
spec:
  replicas: 6
  selector: { matchLabels: { app: api } }
  template:
    metadata: { labels: { app: api } }
    spec:
      topologySpreadConstraints:
        - maxSkew: 1
          topologyKey: topology.kubernetes.io/zone
          whenUnsatisfiable: DoNotSchedule
          labelSelector: { matchLabels: { app: api } }
      affinity:
        nodeAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
            nodeSelectorTerms:
              - matchExpressions:
                  - key: node.kubernetes.io/instance-type
                    operator: In
                    values: ["m7g.large", "m6i.large"]
        podAntiAffinity:
          preferredDuringSchedulingIgnoredDuringExecution:
            - weight: 100
              podAffinityTerm:
                topologyKey: kubernetes.io/hostname
                labelSelector: { matchLabels: { app: api } }
      containers:
        - name: api
          image: ghcr.io/acme/api:1.4.2
---
apiVersion: policy/v1
kind: PodDisruptionBudget
metadata: { name: api-pdb }
spec:
  minAvailable: 75%
  selector: { matchLabels: { app: api } }
10. 흔한 에러와 원인·해결
| 증상 | 원인 | 해결 |
|---|---|---|
OOMKilled (exit 137) |
메모리 limit 초과 | 프로파일링 후 limits 상향, 런타임 컨테이너 인식 플래그 설정 |
| 지연 급증, CPU 미포화 | cgroup CPU 스로틀링 | container_cpu_cfs_throttled_seconds_total 확인, requests=limits |
CrashLoopBackOff |
liveness 오탐 또는 앱 즉시 종료 | kubectl logs --previous, startupProbe로 기동 유예 |
ProgressDeadlineExceeded |
readiness 실패 + maxUnavailable: 0 |
readiness 경로/포트 점검, kubectl describe rs |
HPA <unknown>/70% |
metrics-server 부재 또는 requests 미설정 | metrics-server 설치, requests 정의 |
파드 Pending |
테인트, 자원 부족, 토폴로지 불충족 | kubectl describe pod Events, CA/Karpenter 상태 확인 |
| StatefulSet이 안 뜸 | OrderedReady + 앞 파드 NotReady | 실패 파드 우선 디버깅, 필요 시 Parallel |
| CronJob 누락/중복 | UTC 스케줄 오해, 동시성 미제어 | timeZone 명시, concurrencyPolicy: Forbid |
11. 실무 체크리스트
- 모든 컨테이너에
requests가 있고, 지연 민감 워크로드는requests = limits(Guaranteed)인가 - 느린 기동 앱에
startupProbe가 있고, liveness 경로가 의존성 장애에 반응하지 않는가(오탐 방지) - Deployment에
maxUnavailable/maxSurge,minReadySeconds,progressDeadlineSeconds가 명시되어 있는가 - 롤백 훈련(
kubectl rollout undo --to-revision)이 리허설되어 있고revisionHistoryLimit이 충분한가 - StatefulSet에 Headless Service와
volumeClaimTemplates가 연결되고, PVC 백업/복구 절차가 있는가 - Job/CronJob에
concurrencyPolicy,startingDeadlineSeconds,backoffLimit,ttlSecondsAfterFinished가 설정되었는가 - HPA의
minReplicas가 워크로드 최소 가용성(PDB)과 일치하고,behavior로 스케일 진동을 억제했는가 - VPA와 HPA를 같은 지표로 동시에 쓰지 않았는가
- 노드 확장 경로(CA/Karpenter)에서 requests 기반으로 확장 가능하며, 스팟 축소 시 PDB가 보호하는가
topologySpreadConstraints/anti-affinity로 AZ·노드 분산을 검증하고, 테인트/톨러레이션을 문서화했는가- 파드 삭제·드레인·CA 축소를 실제로 수행해
terminationGracePeriodSeconds와 preStop 훅이 무중단을 보장하는지 확인했는가
12. 정리
- 파드는 일회용, 컨트롤러가 본체다. 파드 집합을 어떤 규칙으로 유지할지가 워크로드 설계의 출발점이다.
- 무상태는 Deployment, 순서·영속성은 StatefulSet, 노드당 하나는 DaemonSet, 완료 보장은 Job/CronJob. 보장이 곧 선택 기준이다.
- requests/limits가 성능과 스케일링의 기준선이다. requests는 스케줄링·HPA의 입력이고, CPU는 스로틀·메모리는 OOMKill이라는 결과 차이를 구분한다.
- Pod 오토스케일러가 먼저, 노드 오토스케일러가 나중. HPA가 늘린 파드가 Pending이 되면 CA/Karpenter가 용량을 확보한다.
- 중단은 예산 안에서. PDB·토폴로지 분산·
terminationGracePeriodSeconds로 드레인과 스케일 축소를 무중단으로 만든다.
References
- Kubernetes Documentation — Workloads
- Kubernetes Documentation — Deployments
- Kubernetes Documentation — StatefulSets
- Kubernetes Documentation — Jobs
- Kubernetes Documentation — Horizontal Pod Autoscaling
- Karpenter — Karpenter Documentation
댓글남기기