
Skills와 MCP는 경쟁이 아니다: SKILL.md 기반 절차 지식과 MCP 연결 계층의 역할 분담
에이전트에 도구를 붙이는 일 자체는 이제 어렵지 않다. MCP(Model Context Protocol) 서버 하나만 있으면 Claude Code, Codex, Cursor, VS Code, GitHub Copilot 같은 클라이언트가 같은 도구를 그대로 쓴다. 그런데 도구를 다 붙이고 나면 다음 질문이 남는다. 그 도구를 어떤 순서로, 우리 팀 규칙에 맞춰 써야 하는지는 누가 알려 주는가?
사내 MCP 서버와 에이전트 도구를 늘려 가는 과정에서 “이 기능은 서버로 만들어야 하나, 아니면 문서 한 장으로 충분한가”를 매번 처음부터 다시 판단하게 되어, 선택 기준을 글로 정리해 두기로 했다. 이 글은 2026년 8월 MCP Dev Summit Seoul 2026에서 공개된 발표 자료(Dale Seo, Apollo GraphQL, “Skills and MCP: Complementary, Not Competing”)1를 참고해 재구성한 독립적인 기술 문서다. 특정 행사의 후기가 아니라, 연결 계층(MCP)과 절차 지식 계층(스킬)을 어떻게 나눠 쓸 것인가에 대한 정리다.
Host–Client–Server 토폴로지, JSON-RPC 2.0 핸드셰이크, Stdio/SSE 전송 계층, Tool·Resource·Prompt 3프리미티브 같은 MCP의 내부 구조는 앞선 글에서 이미 다뤘으므로 여기서는 반복하지 않는다. 이 글의 관심사는 경계다. 스킬이 무엇이고, MCP와 어디서 겹치며, 겹치는 지점에서 무엇을 기준으로 갈라야 하는가.
파트 1: 두 표준의 역사 — 병목은 어디로 이동했나
1.1 MCP가 먼저 푼 문제
MCP는 2024년 11월에 공개됐다. 등장 시점의 표준 배포물은 참조 서버(reference server) 20개 남짓이었고, 목적은 하나였다. 모델과 외부 시스템을 잇는 방법을 클라이언트마다 다시 만들지 않는 것이다.
- 에이전트 클라이언트는 MCP 클라이언트만 구현하면 되고
- 도구 제공자는 MCP 서버만 만들면 되고
- 전송은 stdio(로컬)와 Streamable HTTP(원격) 두 갈래로 정리된다.
이 단계에서 생태계 성장 속도는 상당히 가팔랐다. 공개 초기 20개 수준이던 서버는 2025년 3월 무렵 약 2,000개로, 2025년 11월 무렵에는 공식 레지스트리 기준 20,000개를 넘어섰다1. 즉 1년 만에 “서버를 구현하는 일”이라는 병목은 사실상 해소됐다.
1.2 병목의 이동: 컨텍스트와 절차 지식
문제는 서버가 2만 개를 넘어가면서 다른 곳에서 터졌다.
- 도구가 너무 많다. 연결만 해도 도구 목록이 컨텍스트를 잡아먹는다.
- 도구가 있어도 쓰는 방법을 모른다. MCP는 “무엇을 할 수 있는가”만 알려 주고, “어떤 순서로, 어떤 팀 규칙에 맞춰”는 알려 주지 않는다.
- 문서·설계 원칙·사내 컨벤션 같은 지식은 실시간 API가 아니어서, 굳이 서버를 세워서 제공할 대상도 아니다.
이 지점에서 등장한 것이 스킬(Skill)이다. 스킬은 2025년 12월에 등장했고, 2026년에는 공개 디렉터리에 100만 개 이상의 스킬이 등록됐다2. 숫자의 정확성보다 중요한 건 방향이다. 표준화된 것은 연결이었고, 표준화되지 않은 것은 절차였다.
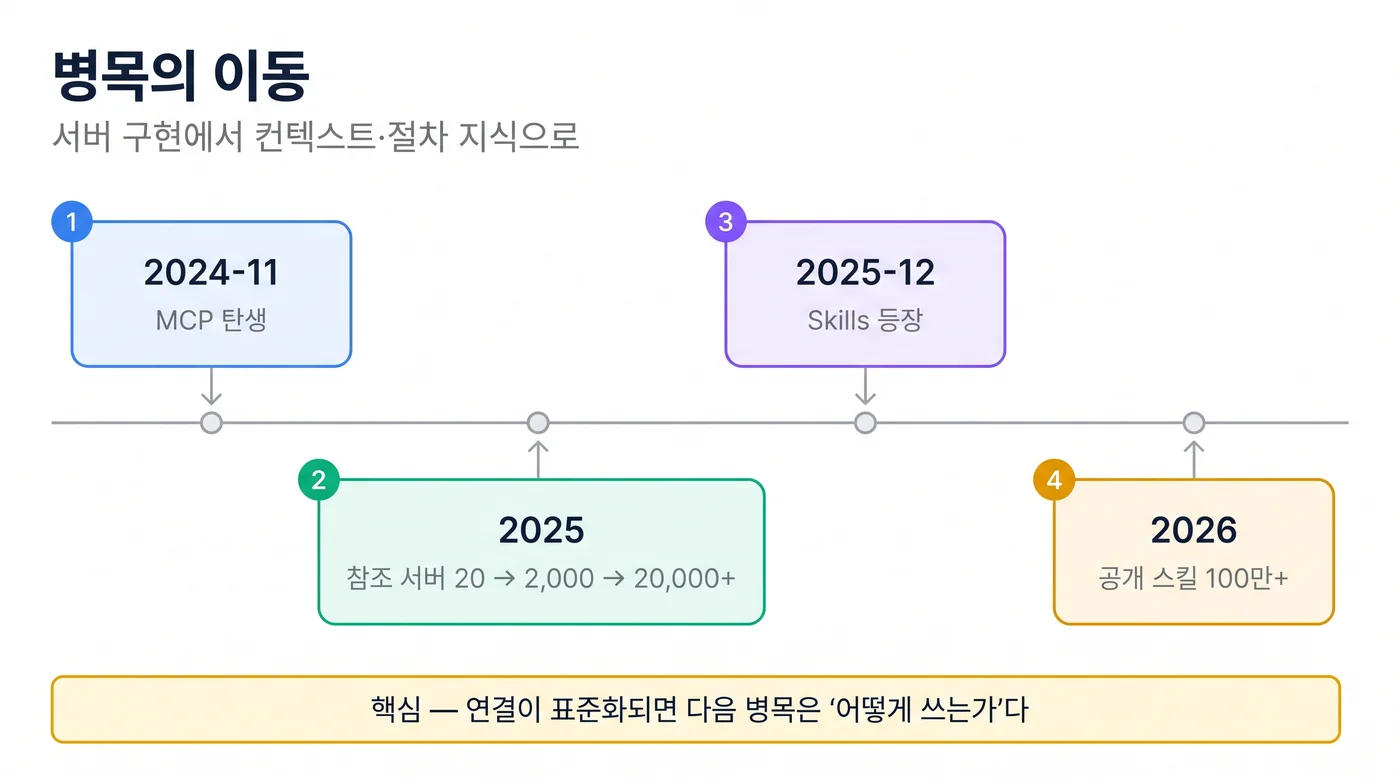
위 도식은 이 글의 논지를 위해 정리한 개념도다.
1.3 스킬이라는 최소 단위
스킬의 정의는 놀랄 만큼 소박하다. SKILL.md 파일이 들어 있는 폴더 하나다.
- 런타임이 필요 없다. 별도 프로세스를 띄우지 않는다.
- 네트워크·인증이 필요 없다. 시크릿을 들고 다니지 않는다.
- 배포가 저장소 커밋이다. 리뷰도 코드 리뷰와 같은 방식으로 한다.
MCP 서버를 세우는 비용(호스팅, 인증, 장애 대응)과 스킬을 추가하는 비용(마크다운 한 장)은 자릿수가 다르다. 이 비대칭이 뒤에서 다룰 모든 선택 기준의 출발점이다.
파트 2: 스킬의 구조와 점진적 공개
스킬이 실제로 어떤 파일과 폴더로 구성되고, 어떤 순서로 컨텍스트에 올라오는지 살펴본다.
2.1 SKILL.md가 들어 있는 폴더
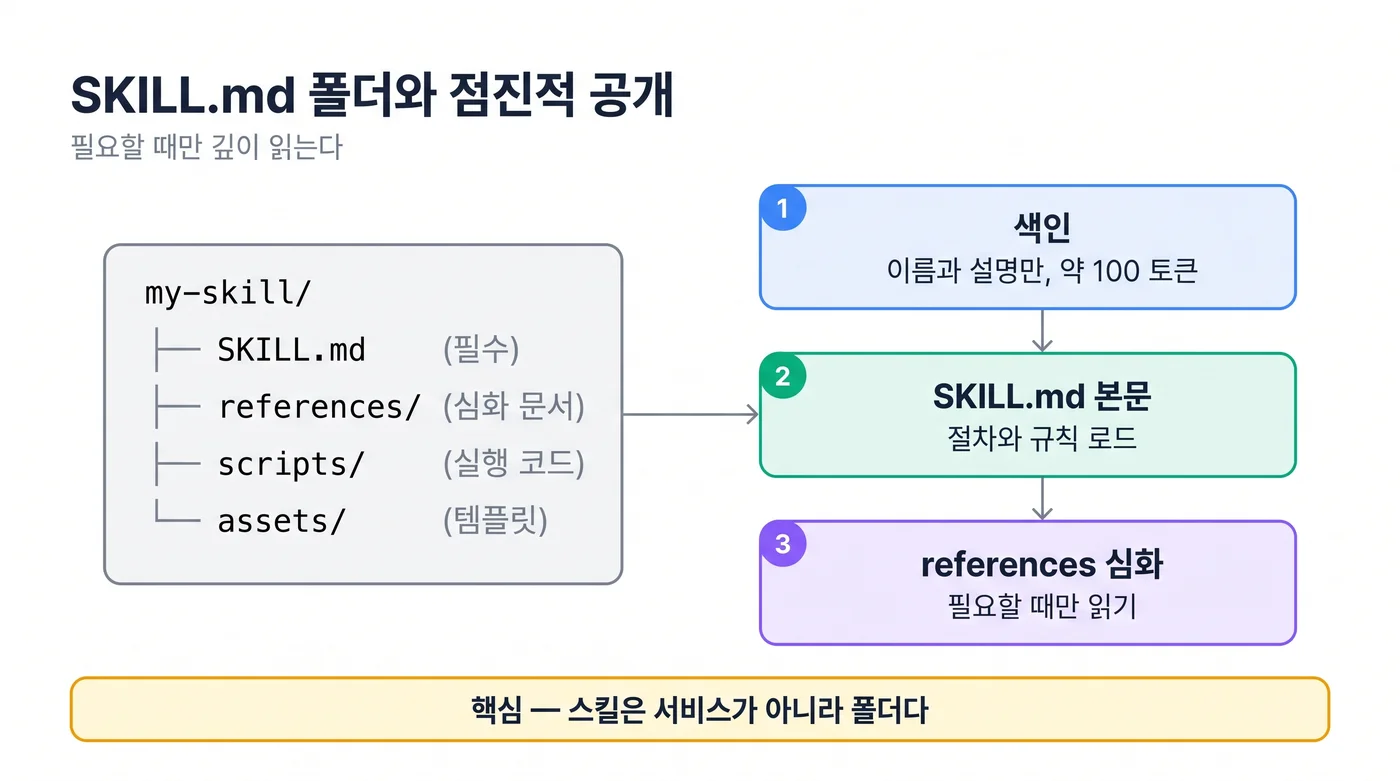
스킬 폴더는 필수 파일 하나와 선택 디렉터리 셋으로 구성된다. 구조는 다음과 같다3.
my-skill/
├── SKILL.md            # 필수 — YAML 프론트매터 + 마크다운 본문
├── references/         # 선택 — 깊이 있는 참고 문서
│   ├── queries.md
│   ├── mutations.md
│   └── caching.md
├── scripts/            # 선택 — 실행 가능한 코드
│   ├── run-codegen.sh
│   └── check-config.sh
└── assets/             # 선택 — 템플릿·리소스
    └── provider.tsx
SKILL.md의 프론트매터는 최소한 이름과 설명을 갖는다. 실제 사내 스킬 템플릿은 이런 모양이 된다.
---
name: azure-aks-deploy
description: >
  AKS에 워크로드를 배포하는 사내 표준 절차. 다음 상황에서 사용한다.
  (1) 새 서비스를 처음 배포할 때, (2) 롤아웃 전략을 변경할 때,
  (3) 배포 후 검증 체크리스트가 필요할 때.
license: MIT
---

# AKS 배포 표준

## 사전 확인
1. 이미지 태그가 digest로 고정됐는지 확인한다.
2. `values-<env>.yaml`에 리소스 요청/제한이 있는지 확인한다.

## 배포
1. 스테이징에 먼저 배포하고 5분간 5xx 비율을 관찰한다.
2. 프로덕션은 카나리 10% → 50% → 100% 순서로 올린다.

## 검증
- 레디니스 프로브 실패가 0건인지 확인한다. 세부 판단 기준은
  references/deploy-checklist.md 참고.
여기서 눈여겨볼 점은 description이 검색 키이자 트리거 조건이라는 사실이다. “언제 이 스킬을 써야 하는가”를 문장으로 적어 두지 않으면, 에이전트는 그 스킬의 존재를 알아도 꺼내 쓰지 않는다.
2.2 점진적 공개(progressive disclosure)
스킬의 핵심 설계는 로딩을 세 단계로 쪼갠 것이다4.
스킬 컨텍스트 로딩 (3단계)
┌──────────────────────────────────────────────┐
│ 1단계  name + description   (대략 100 토큰)  │  ← 항상 로드
├──────────────────────────────────────────────┤
│ 2단계  SKILL.md 본문        (수백~수천 토큰) │  ← 해당 스킬을 고른 시점
├──────────────────────────────────────────────┤
│ 3단계  references/ 문서     (필요한 만큼)    │  ← 작업 도중 필요할 때
└──────────────────────────────────────────────┘
비유하자면 오픈북 시험이다. 시험장에 참고서를 전부 펼쳐 놓는 대신, 목차(1단계)만 외우고 문제를 읽은 뒤 해당 챕터(2단계)를 펼치고, 계산이 필요하면 부록(3단계)을 찾는다. 컨텍스트 창은 유한한 자원이므로, 무엇을 언제 올릴지 결정하는 것 자체가 설계 행위다.
2.3 MCP의 로딩 방식과 무엇이 다른가
MCP 서버는 연결 시점(load on connect)에 도구 목록을 컨텍스트에 올린다. 도구가 12개면 12개가, 40개면 40개가 그대로 들어간다. 스킬은 사용 시점(load on use)에 단계적으로 올라온다4.
| 항목 | MCP 서버 | 스킬 |
|---|---|---|
| 로딩 시점 | 연결 시 도구 목록 전체 | 이름+설명 → 선택 시 본문 → 필요 시 참조 |
| 컨텍스트 비용 | 도구 수에 비례(항상 지불) | 색인 고정 + 본문 온디맨드 |
| 지식의 성격 | 실행 가능한 기능 | 읽고 따르는 절차·규칙 |
| 변경 반영 | 서버 배포 시 즉시 | 저장소 커밋·동기화 시점 |
| 실패 모드 | 컨텍스트 포화, 권한 오남용 | 문서 표류(drift), 오래된 절차 |
이 차이가 뒤에 나오는 트레이드오프를 거의 전부 설명한다.
파트 3: 무엇을 스킬로, 무엇을 MCP 서버로 보낼까
3.1 두 표준의 업무 분담
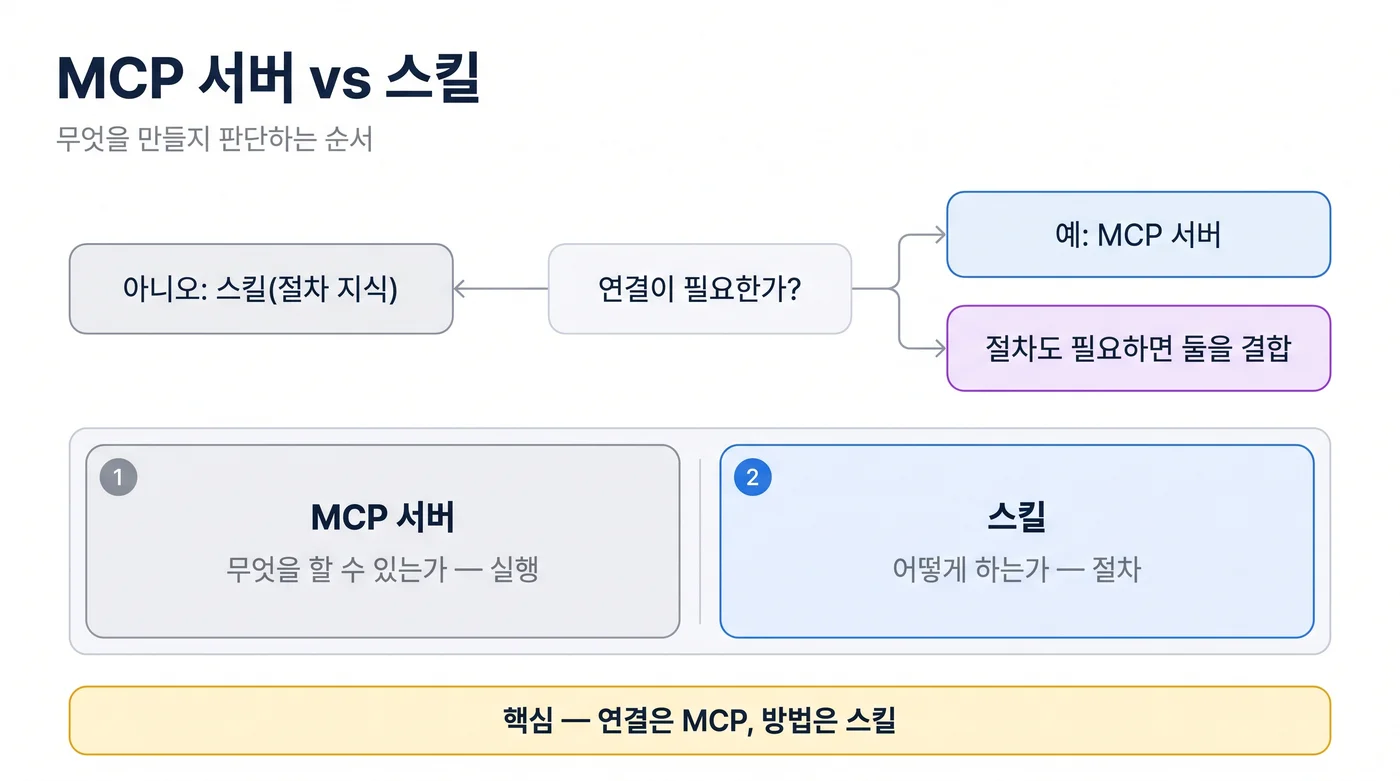
두 표준은 각각 한 줄로 요약된다. MCP는 what to do, 스킬은 how to do it5.
- MCP가 잘하는 것
- 실시간 데이터(live data): 배포 상태, 주문 현황, 장애 메트릭
- 호스팅 액션(hosted actions): 티켓 생성, 배포 트리거, 알림 발송
- 인증된 API(authenticated APIs): 사내 시스템, SaaS 커넥터
- 스킬이 잘하는 것
- 팀 컨벤션(team conventions): 브랜치 전략, 리뷰 규칙, 네이밍
- 도메인 지식(domain expertise): 우리 서비스의 구조, 과거 장애 패턴
- 모범 사례(best practices): 라이브러리 사용법, 설계 원칙
오해는 정확히 겹치는 지점에서 시작한다. 어떤 지식은 양쪽으로 다 전달할 수 있기 때문이다.
3.2 변경 속도 스펙트럼
두 번째 판단 축은 변경 속도(rate of change)다6.
        매 요청마다 달라짐                        거의 달라지지 않음
  ◀───────────────────────────────────────────────────────────────▶
  live customer data   deploy & incident state   library docs   design principles
        │                       │                       │              │
        └────── MCP ────────────┘                       └── Skills ────┘
                                                    ▲
                                        매주 배포되는 제품 문서 = 애매한 구간
- 실시간 고객 데이터, 배포·장애 상태 → 서버가 답을 가져야 한다. 스킬로는 표현할 수 없다.
- 라이브러리 문서, 설계 원칙 → 스킬로 충분하고, 오히려 서버를 세우면 과잉이다.
- 매주 배포되는 제품의 문서 → 둘 다 가능하다. 여기가 실제로 다툼이 생기는 구간이다.
3.3 같은 문서로 가는 두 경로
같은 문서를 두 방식 모두로 제공할 수 있다7.
| 경로 | 절차 | 특징 |
|---|---|---|
| 스킬 | 설치한 뒤 읽는다 | 인프라 없음, 버전이 고정되어 표류 가능 |
| MCP 서버 | 연결한 뒤 가져온다 | 항상 최신, 호스팅·인증 비용 발생 |
즉 “무엇을 제공할 수 있는가”의 문제가 아니라 “최신성을 누가 감당할 것인가” 의 문제다. 문서가 자주 바뀌고 최신성이 중요하면 서버, 사용자 환경에 설치되어 실행되는 게 자연스럽고 인프라를 만들기 싫으면 스킬이다.
3.4 선택 기준 체크리스트
실무에서는 다음 순서로 물으면 대부분 결론이 난다.
- 최신 데이터가 필요한가? → 예면 MCP.
- 부작용(쓰기)이 있는가? → 예면 MCP. 스킬은 아무것도 실행하지 않는다.
- 시크릿·인증이 필요한가? → 예면 MCP. 스킬 폴더에 토큰을 넣는 순간 리뷰 정책이 무너진다.
- 그냥 절차·규칙·판단 기준인가? → 예면 스킬.
- 모델이 이미 아는 내용인가? → 예면 아무것도 만들지 않는다. 이 조건은 파트 6에서 다시 다룬다.
파트 4: 함께 쓰는 패턴
4.1 스킬은 절차를, MCP는 실행을
둘은 경쟁 관계가 아니라 한 워크플로의 두 층이다.
- 스킬은 런북(runbook) 역할을 한다. 어떤 순서로, 무엇을 확인하고, 어디까지는 자동으로 하고 어디서 사람에게 물어볼지를 적어 둔다.
- MCP는 손 역할을 한다. 스킬이 지시한 순서대로 실제 API를 호출하고 데이터를 가져온다.
즉 스킬이 “MCP 도구 사용법”을 안내하고, MCP가 “실제 실행”을 맡는 구조다. 스킬 본문에 references/로 도구별 호출 예시를 넣어 두면, 에이전트는 불필요한 도구를 미리 컨텍스트에 올리지 않고도 정확한 호출 순서를 알 수 있다.
4.2 사후분석 보고서 예시
오케스트레이션 예시 하나가 이 구조를 잘 보여 준다. 사용자는 "Write up last night's incident." 한 문장만 입력한다. 그러면 postmortem 스킬이 절차를 잡고, 여러 MCP 서버가 각 단계를 실행한다8.
                    ┌──────────────┐
사용자 한 문장 ───▶ │ postmortem   │  ← 스킬: 순서와 판단 기준
                    │   skill      │
                    └──────┬───────┘
                           │  단계별로 필요한 도구만 호출
   ┌───────────────────────┼───────────────────────┐
   ▼           ▼           ▼           ▼           ▼
PagerDuty   Slack      Datadog    GitHub     incident.io
(타임라인,  (워룸 스레드, (에러율·   (스파이크  (서사 발행)
 UTC 재확인)  #inc-4417)  지연)      전 머지)
   │
   ├──▶ Google Calendar (리뷰 미팅 예약)
   └──▶ Jira (액션 아이템별 티켓 + 담당자)
핵심은 스킬이 없으면 순서를 모르고, MCP가 없으면 데이터를 못 가져온다는 점이다. 실제로 이 예시에서 에이전트가 잘하는 일은 개별 API 호출이 아니라, UTC 타임라인을 다시 확인하고(22 → 9+13처럼 시간대를 재계산) 스파이크 이전에 머지된 변경을 대조하는 판단 절차다.
4.3 반쪽만 있으면 워크플로가 아니다
| 구성 | 결과 |
|---|---|
| 스킬만 있고 MCP가 없음 | 절차는 알지만 데이터가 없다. 결국 사람이 복사·붙여넣기 한다 |
| MCP만 있고 스킬이 없음 | 도구는 있지만 순서와 규칙이 없다. 매번 즉흥적으로 호출한다 |
| 스킬 + MCP | 절차에 따라 데이터를 가져오고, 확인 지점에서 멈춘다 |
“어느 한쪽만으로는 워크플로가 아니다(Neither half is the workflow)”라는 정리가 여기서 나온다9.
파트 5: 컨텍스트 비용과 토큰 예산
5.1 도구 하나하나가 청구서다
도구는 공짜로 컨텍스트에 올라가지 않는다. 이름, 설명, 입력 스키마(JSON Schema)가 모두 토큰을 소비하고, 그 비용은 매 요청마다 반복 지불된다. 도구가 많은 서버를 하나 붙이는 것만으로 대화 여유분이 줄어드는 이유다.
이 문제에 대한 업계의 반응은 두 갈래로 나타났다10.
- 로컬 MCP → CLI + 스킬: 굳이 서버 프로세스를 띄우지 않고, 이미 있는 CLI와 스킬로 대체하는 흐름
- 원격 MCP로 수렴: Claude, ChatGPT 같은 클라이언트들이 원격 MCP를 기본 경로로 삼는 흐름
둘은 모순이 아니다. 상시 연결이 필요한 것은 원격으로, 로컬에서 돌아가는 절차는 스킬로 간다는 뜻이다.
5.2 서버 분리와 도구셋 분할
컨텍스트를 줄이는 실무 기법은 두 가지다11.
- 서버 분리: 문서용 서버와 스캔용 서버를 나눠, 필요한 쪽만 연결한다. (한 서버에 모든 도구를 몰아넣지 않는다)
- 도구셋 분할(toolsets by audience): 하나의 서버 안에서도 기본 로드되는 도구셋과 그렇지 않은 도구셋을 나눈다.
도구셋 분할 예시 (개념)
┌───────────────────────────────┬───────────────────────────────┐
│ 기본 로드 (schema)            │ 미로드 (insights)             │
├───────────────────────────────┼───────────────────────────────┤
│ 최근 실행 조회                │ 상위 오퍼레이션               │
│ 실행 로그·린트 결과 조회       │ 오퍼레이션·서브그래프 메트릭    │
│ 스키마 검사                   │ 에러율                        │
│ 서브그래프 SDL 조회           │                               │
└───────────────────────────────┴───────────────────────────────┘
5.3 스킬의 컨텍스트 예산
스킬은 같은 문제를 다른 방식으로 푼다.
- 색인 비용은 스킬당 대략 100 토큰 수준으로, 도구 스키마보다 훨씬 싸다4.
- 대신
description이 곧 검색 키다. 설명이 부실하면 색인만 차지하고 선택되지 않는다. - 그래서 스킬은 잘게 쪼개는 편이 낫다. “AKS 배포”와 “AKS 장애 트리아지”는 하나의 큰 스킬보다 두 개의 작은 스킬이 검색 정확도와 토큰 효율 모두에서 유리하다.
- 본문은 짧게, 깊은 내용은
references/로 밀어낸다. 이것이 점진적 공개를 실제로 작동시키는 유일한 방법이다.
파트 6: 실서비스에서 얻은 교훈
6.1 무엇을 출시할지는 사용자가 고른다
“스킬과 MCP 중 무엇을 만들어야 하나”라는 질문은 대개 잘못된 질문이다. 같은 기능을 두 표면(surface)으로 제공하고 사용자가 고르게 하는 편이 낫다. 스킬과 MCP 서버를 병행 제공하면, 문서만 읽고 싶은 사용자와 자동화까지 원하는 사용자를 모두 만족시킬 수 있다12.
6.2 델타가 없으면 스킬도 없다
가장 중요한 교훈이다. 모델이 이미 아는 내용을 스킬로 포장하지 않는다. CLI를 예로 들면, 대부분의 명령은 이미 모델이 학습으로 알고 있으므로, 스킬에는 새로 추가되거나 바뀐 명령만 담는다. 델타가 없으면 스킬은 컨텍스트만 차지하는 잉여 문서가 된다13.
6.3 바이너리가 아니라 URL을 배포한다
MCP 서버를 어디에 띄울 것인가에 대한 결론은 원격 쪽으로 기울었다. 바이너리를 배포하는 대신 URL을 배포한다. 그러면 사용자 쪽 설치·업데이트 부담이 사라지고, 인증과 관측을 서버 쪽에서 통제할 수 있다14.
6.4 스킬은 누가 쓰는가 — 개인에서 조직으로
스킬의 저자는 벤더만이 아니다. 스킬 계층은 개인 스킬(Personal Skills) → 팀 스킬(Team Skills) → 조직 스킬(Organization Skills) 세 단계로 나뉜다15. 조직이 기반(foundation)을 배포하고, 그 위에 팀과 개인이 얹는 구조다. 개인 스킬은 저장소 밖에 있어도 되지만, 팀 스킬부터는 리뷰와 소유자가 필요하다.
실무 적용: 팀 스킬 저장소와 MCP 서버로 나누는 기준
여기서부터는 사내 MCP 서버 몇 개와 에이전트 도구를 Azure/Kubernetes 위에서 운영하는 상황을 가정한다. 목표는 “무엇을 만들까”를 매번 토론하지 않고, 저장소 구조와 판단표로 즉시 결정하는 것이다.
팀 스킬 저장소 구조
스킬을 코드처럼 관리한다. 별도 서비스가 아니라 Git 저장소 하나면 충분하다.
platform-skills/
├── README.md                       # 스킬 목록·소유자·리뷰 정책
├── .github/workflows/skill-lint.yml
├── conventions/                    # 팀 컨벤션 (사람이 읽는 규칙)
│   ├── k8s-deploy-standard/
│   │   ├── SKILL.md
│   │   ├── references/deploy-checklist.md
│   │   └── scripts/verify-rollout.sh
│   └── incident-triage/
│       ├── SKILL.md
│       └── references/triage-tree.md
├── llm-platform/                   # LLM/RAG 운영 절차
│   ├── rag-eval-runbook/
│   │   ├── SKILL.md
│   │   └── references/metrics.md
│   └── prompt-change-review/
│       └── SKILL.md
└── vendor/                         # 벤더 배포 스킬 미러 (수정 금지, 버전 고정)
    └── <vendor-skill>/
- 디렉터리 깊이는 2단계까지. 카테고리는 “지식의 종류”가 아니라 호출되는 맥락 기준으로 나눈다.
vendor/처럼 외부에서 받은 스킬은 개별 디렉터리로 격리하고, 사내 규칙과 섞지 않는다.- 모든 스킬에
OWNERS(또는 README 표의 소유자 열)를 둔다. 소유자 없는 스킬은 분기 감사에서 제거 대상이다.
스킬 리뷰·버전 관리 절차
- PR 생성: 스킬 추가·수정은 반드시 PR.
SKILL.md단독 수정도 PR이다. - 자동 검증(CI): 프론트매터 필수 키,
description존재 여부, 링크 유효성, 시크릿 패턴 검사를 돌린다.
name: skill-lint
on:
  pull_request:
    paths: ["**/SKILL.md", "**/references/**"]
jobs:
  lint:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - name: 스킬 프론트매터 검증
        run: python3 scripts/validate_skill.py --all
      - name: PR 번호 기록
        run: echo "reviewed in PR #${{ github.event.pull_request.number }}"
- 리뷰 기준: ①
description에 트리거 조건이 문장으로 있는가 ② 델타가 있는가(모델이 이미 아는 내용을 반복하지 않는가) ③ 참조하는 MCP 도구 이름이 실재하는가 ④ 시크릿·내부 URL이 본문에 하드코딩되지 않았는가. - 버전 관리: 시맨틱 버전 대신
last_modified_at+ 변경 이력 절을 쓴다. 절차 지식은 API가 아니므로 “언제 바뀌었는지”가 “몇 번째 버전인지”보다 중요하다. - 감사: 분기마다 ① 참조한 MCP 도구가 아직 존재하는지 ② 절차가 실제 운영과 일치하는지 확인한다. 문서 표류(drift)는 스킬의 유일한 실패 모드다.
어떤 지식을 스킬로, 어떤 기능을 MCP 서버로 보낼까
| 판단 질문 | 스킬 | MCP 서버 |
|---|---|---|
| 최신 데이터가 필요한가 | 아니오 — 문서·규칙·판단 기준 | 예 — 배포 상태, 메트릭, 티켓 |
| 부작용(쓰기)이 있는가 | 없음 (읽기 전용 지식) | 있음 (생성·변경·삭제) |
| 인증·시크릿이 필요한가 | 불필요 | 필요 (OAuth, 서비스 토큰) |
| 변경 주기 | 주 단위 문서 리뷰 | API 변경 시 |
| 배포 형태 | 저장소 폴더 (설치·동기화) | 원격 URL (호스팅·인증 포함) |
| 컨텍스트 비용 | 색인 ~100 토큰 + 온디맨드 | 연결 시 도구 목록 전체 |
| 실패 시 영향 | 에이전트가 잘못된 절차를 따름 | 권한 오남용·데이터 변경 |
| 소유자 | 팀(문서 리뷰어) | 플랫폼 팀(SRE) |
| 함께 쓰는 형태 | 절차·순서·확인 지점 제공 | 스킬이 지시한 호출을 실행 |
경계가 애매하면 스킬 먼저, 필요해지면 서버 원칙을 적용한다. 서버는 되돌리기 비싸고, 스킬은 되돌리기 싸다.
사내 에이전트 온보딩에 적용하는 순서
| 단계 | 하는 일 | 산출물 | 성공 지표 |
|---|---|---|---|
| 0. 측정 | 개인이 반복하는 절차를 2주간 기록 | 후보 목록(10개 이내) | 반복 횟수·소요 시간 |
| 1. 개인 스킬 | 상위 2~3개를 개인 스킬로 작성 | SKILL.md 2~3장 |
사람이 손으로 하던 단계 감소 |
| 2. 팀 저장소 승격 | 리뷰·소유자 지정 후 conventions/로 이동 |
PR + CI 통과 | 리뷰 지적 반영률, 재사용 팀 수 |
| 3. MCP 서버 추가 | 스킬이 막히는 지점(실시간 데이터·쓰기)만 서버화 | 원격 URL | 도구 호출 성공률, 승인 대기 시간 |
| 4. 조직 배포 | 온보딩 문서를 스킬로 대체 | 조직 스킬 세트 | 신규 입사자 온보딩 소요일 |
| 5. 감사 | 분기별 도구·절차 정합성 점검 | 감사 리포트 | 표류 스킬 수(0에 수렴) |
도입 전 체크리스트
- 이 스킬은 델타가 있는가? (모델이 이미 아는 내용을 반복하지 않는가)
description에 “언제 쓰는가”가 문장으로 적혀 있는가?- 본문은 짧고, 깊은 내용은
references/로 빠져 있는가? - 스킬이 참조하는 MCP 도구 이름이 실제로 존재하는가?
- 폴더 안에 시크릿·토큰·내부 전용 URL이 없는가?
- 새로 연결하는 MCP 서버의 도구 목록이 컨텍스트 예산 안에 들어오는가?
- 자주 쓰지 않는 도구는 도구셋 분할로 기본 로드에서 제외했는가?
- 소유자와 리뷰 주기가 정해져 있는가?
- 쓰기 도구에는 사용자 승인(Human-in-the-loop) 지점이 있는가?
- 이 지식을 스킬로도 서버로도 제공할 수 있다면, 최신성을 누가 감당하는가를 정했는가?
References
| 구분 | 내용 |
|---|---|
| 세션 | “Skills and MCP: Complementary, Not Competing” |
| 스피커 | Dale Seo, Software Engineer, Apollo GraphQL |
| 소속·활동 | Apollo MCP Server, Apollo Skills, GraphOS MCP Server / Rust MCP SDK(rmcp) maintainer |
| 행사 | MCP Dev Summit Seoul 2026 (2026년 8월) |
| 행사 페이지 | https://events.linuxfoundation.org/mcp-dev-summit-seoul/ |
| 세션 스케줄 | https://mcpseoul2026.sched.com/ |
-
Dale Seo, “Skills and MCP: Complementary, Not Competing”, MCP Dev Summit Seoul 2026 — MCP 탄생(2024년 11월)과 생태계 성장 타임라인 슬라이드. ↩ ↩2
-
같은 발표 — “The bottleneck shifted” 슬라이드. 스킬 등장 시점과 공개 디렉터리 등록 스킬 수. ↩
-
같은 발표 — “It’s just a folder with SKILL.md” 슬라이드의 폴더 구조와 프론트매터 예시. ↩
-
같은 발표 — “Loaded on connect, or loaded on use” 슬라이드의 3단 로딩 구조. ↩ ↩2 ↩3
-
같은 발표 — “Different jobs, mostly” 슬라이드(MCP = what to do / Skills = how to do it). ↩
-
같은 발표 — “The rate of change” 슬라이드. ↩
-
같은 발표 — “two routes to the same source” 슬라이드(설치 후 읽기 vs 연결 후 가져오기). ↩
-
같은 발표 — “Orchestration” 슬라이드(사후분석 워크플로와 참여 시스템 목록). ↩
-
같은 발표 — “Neither half is the workflow” 슬라이드. ↩
-
같은 발표 — “Local MCP gives way to CLI + Skills”, “Vendors converge on remote MCP” 슬라이드. ↩
-
같은 발표 — “Every tool is a bill” 슬라이드(서버 분리·도구셋 분할 예시). ↩
-
같은 발표 — “Let your users choose the surface” 슬라이드. ↩
-
같은 발표 — “No delta, no skill” 슬라이드. ↩
-
같은 발표 — “Ship a URL, not a binary” 슬라이드. ↩
-
같은 발표 — “Publish the foundation” 슬라이드(Personal → Team → Organization Skills). ↩
댓글남기기